腾讯开源 Hy4 flash:单任务成本降到 Hy4 的二十分之一
腾讯宣布开源 Hy4 flash,该模型的总参数是 220B,每个 token 只激活 12B。这个比例本身就是这次发布的核心卖点。混元团队在模型卡…
腾讯宣布开源 Hy4 flash,该模型的总参数是 220B,每个 token 只激活 12B。这个比例本身就是这次发布的核心卖点。混元团队在模型卡…
开发者围绕同一块基础模型进行实验,让模型直面成功的方法、失败的经验和真实世界的问题。 作者|Li Yuan 编辑| 郑玄 最大规模具身大模型挑战赛总…
Sarvam Token Factory 现已向所有人开放。它通过一个与 OpenAI 兼容的 API,由印度的 GPU 集群为 Sarvam 10…

11 月 16 日,「DeepSeek 使用额度已达上限」冲上热搜。多名用户反馈,App 和网页端同时收紧了限制,而且一次收了三条。 最直接的一条:…
比 DeepSeek V4.1 Flash 性价比更高
11月16日,千问办公一口气上线10款模型,包括刚刚发布的Qwen4-Max,以及Kimi、GLM、DeepSeek、MiniMax、Step等多款…
IT之家 11 月 16 日消息,昨日有部分用户反馈称,DeepSeek 已对 App 与网页版的长对话功能实施了使用限额。 多名用户收到平台提示,…
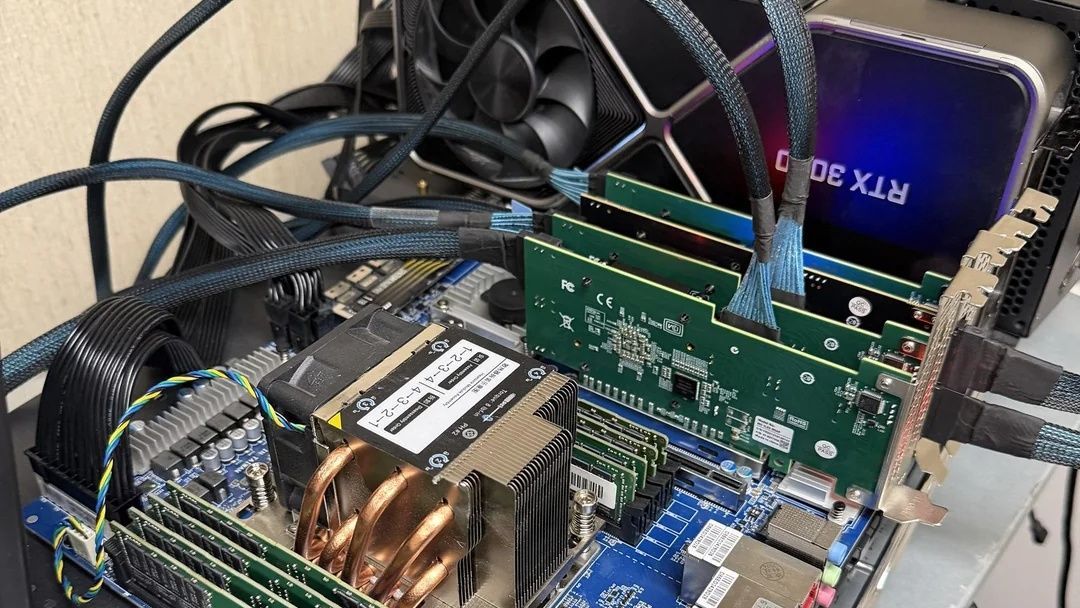
一位律师的八卡 NVIDIA V100 服务器现在以 NVFP4 精度运行 DeepSeek V4.1 Flash 中使用最频繁的专家,而非 2-b…
官方App功能均可自由组合调用
前 OpenAI 研究员 Will DePue 称,他拿出了首个技术证据,表明 DeepSeek、Moonshot AI、MiniMax 和 Ant…

模型架构决定了 LLM 的扩展行为、训练效率与推理成本,因而成为产业界和学术界共同关注的核心。在产业界,DeepSeek、Qwen 和 Kimi 背…
模型架构决定 LLM 的扩展行为、训练效率与推理成本,因此是产业界和学术界共同关注的核心。在产业界,DeepSeek、Qwen、Kimi 背后的团队…
据三名直接知情人士透露,与 Alice Huang 有关联的公司网络近期投资了中国 AI 明星企业 DeepSeek。Alice Huang 被指为…
头图来源:豆包工作官网 豆包工作也模型自由了。 11 月 12 日,豆包工作宣布接入 Kimi K3.1 Pro、GLM 5.3、DeepSeek…
国产大模型开始组团办公
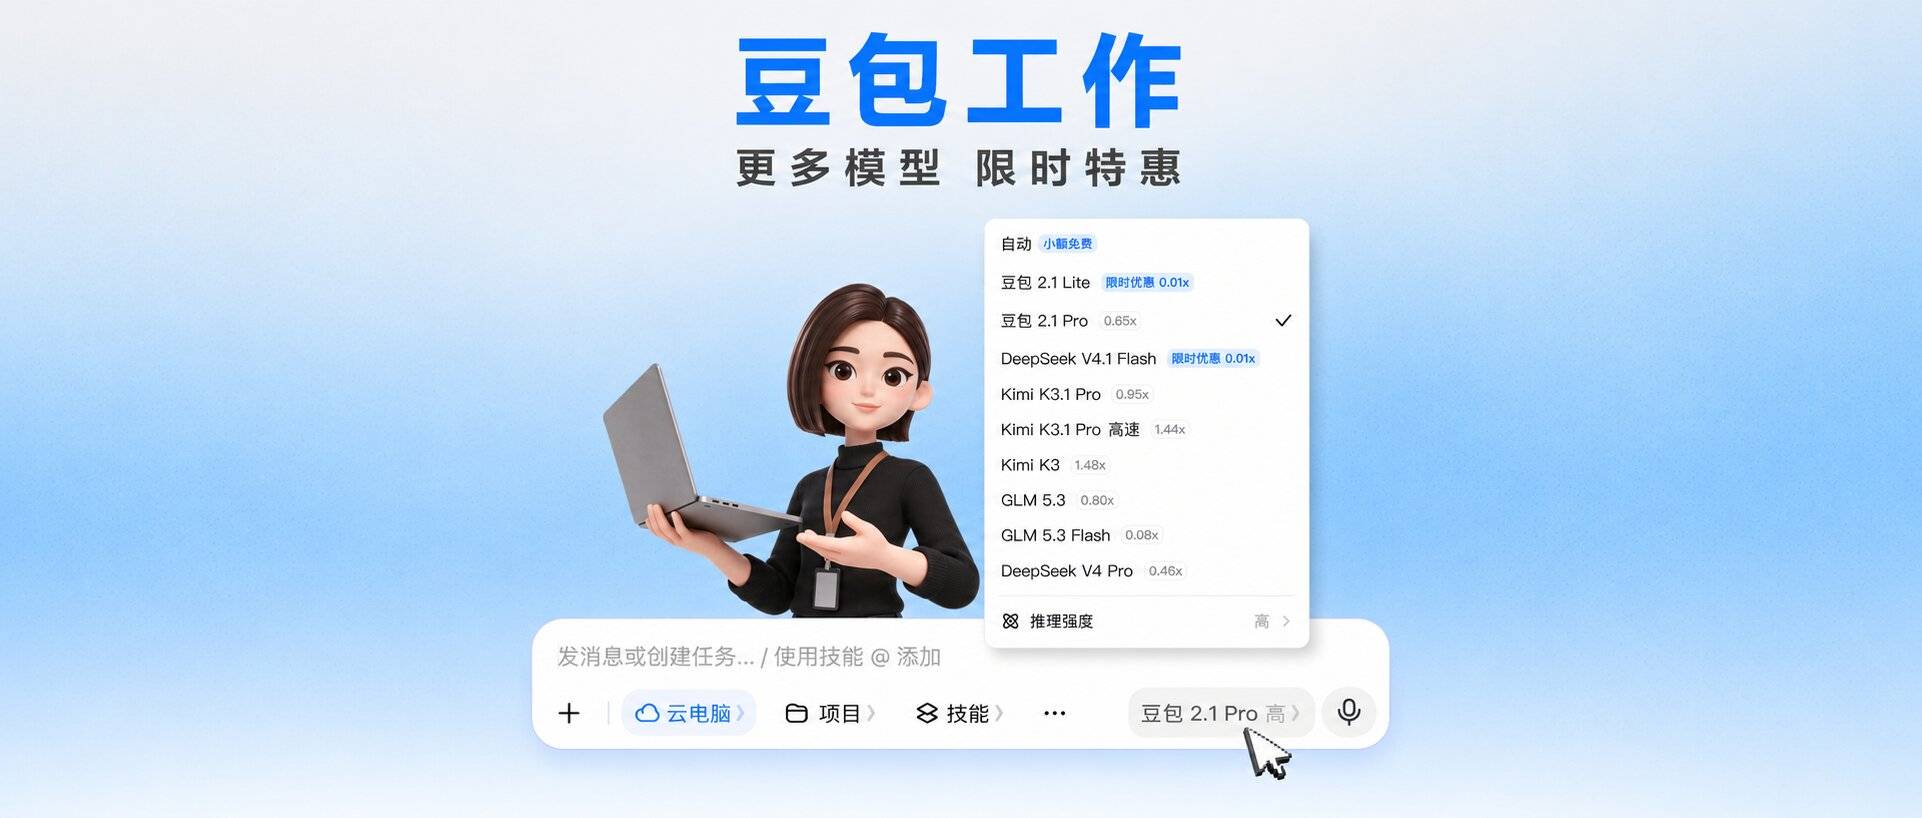
为满足用户根据不同任务自主选择模型的需求,11月12日,豆包工作正式接入 Kimi 3.1 Pro、GLM 5.3、DeepSeek V4.1 Fl…
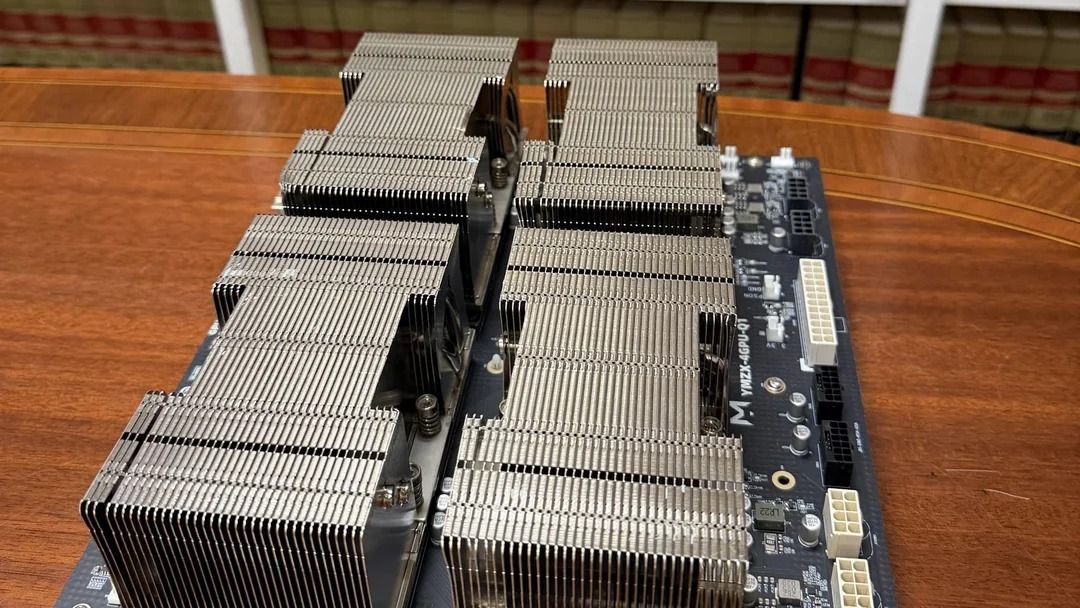
一位律师在八块 2018 年出厂的二手 Nvidia V100 GPU 上运行 DeepSeek V4.1 Flash,速度最高达 215 Toke…
对 10 个开放 MoE 模型如何路由 Token 的配置核验式对比:总参数与激活参数、专家数量、top-k、共享专家、门控函数以及负载均衡方法。
MoE 路由策略决定每个 Token 由哪些专家处理。本指南讲解 7 种方法,从 Mixtral 的 top-2 softmax 到 DeepSee…

在 Vals AI 基准测试中,OpenAI 的 GPT-6 Sol Daybreak 在模拟企业网络中达成 80.8% 的攻击目标。更糟的是,开放…
苦单Session久矣,两大Agent玩家不谋而合。
Q3营收实现数倍增长

DeepSeek V4.1 Flash 把输入价压到 0.156 美元,Kimi K3.1 Pro 以 46 分刷新开源上限,GLM-5.3-Fla…

DeepSeek 发布全新 Agent 架构 10 月 31 日晚间,DeepSeek Harness 团队在官方公众号发表技术文章《Super-…
国行 Apple 智能确定上线时间:11 月开放测试,千问接入 Siri 10 月 31 日,苹果宣布,国行 Apple 智能首批功能将于 11 月…
苹果发布首款触屏 MacBook Pro,顶配超 11 万 元 北京时间 10 月 29 日,苹果发布全新 MacBook Pro,首次为 Mac…