MoE-LoRA 多语言适配方法:系统性实证研究
路由式低秩适配器提供了一种参数高效的手段,可提升大语言模型(LLM)在各类任务上的表现。因此,人们认为它们也可用于改善对低资源语…
路由式低秩适配器提供了一种参数高效的手段,可提升大语言模型(LLM)在各类任务上的表现。因此,人们认为它们也可用于改善对低资源语…
在 Gemma 4 31B 的全局注意力层中,value 是归一化后的 key 投影,key 则是 value 乘以一个固定权重,并在其四分之一维度…
在 Gemma 4 31B 的全局注意力层中,value 是归一化后的 key 投影,而 key 是 value 乘以一个固定权重,并对其四分之一维…
稀疏注意力已越来越多地被生产环境中的 LLM 用于长上下文推理,但服务系统仍必须保留完整的 KV 历史,这使 GPU 的高带宽内存(HBM)容量成为…
块式扩散语言模型(DLM)可并行细化多个 Token,为逐 Token 自回归解码提供了另一种选择。然而其长上下文推理仍受制于内存瓶颈…
选择 Transformer 等标准神经网络架构,是因为它们能用梯度下降很好地训练,并在 GPU 上运行得很快。在权重空间编程中,大语言模型(LLM…
智能体式工作负载、长文档和大型代码库正将上下文长度从数万 Token 推向数十万 Token。在这样的长度下,……

阿里巴巴发布 Qwen4-Max,这是一款专有的 2.4T 参数混合专家模型,拥有 71B 激活参数、原生视觉能力和 100 万 Token 上下文…
本文结合美团基础技术部在 AI 评审、问题排查和自动化开发中的真实实践,分享 AI 能帮上什么忙、容易在哪些地方犯错,以及哪些地方仍需要人来把关。比…
本文分享这套系统的设计理念、架构演进与可信度设计,希望对大家有所帮助或启发。

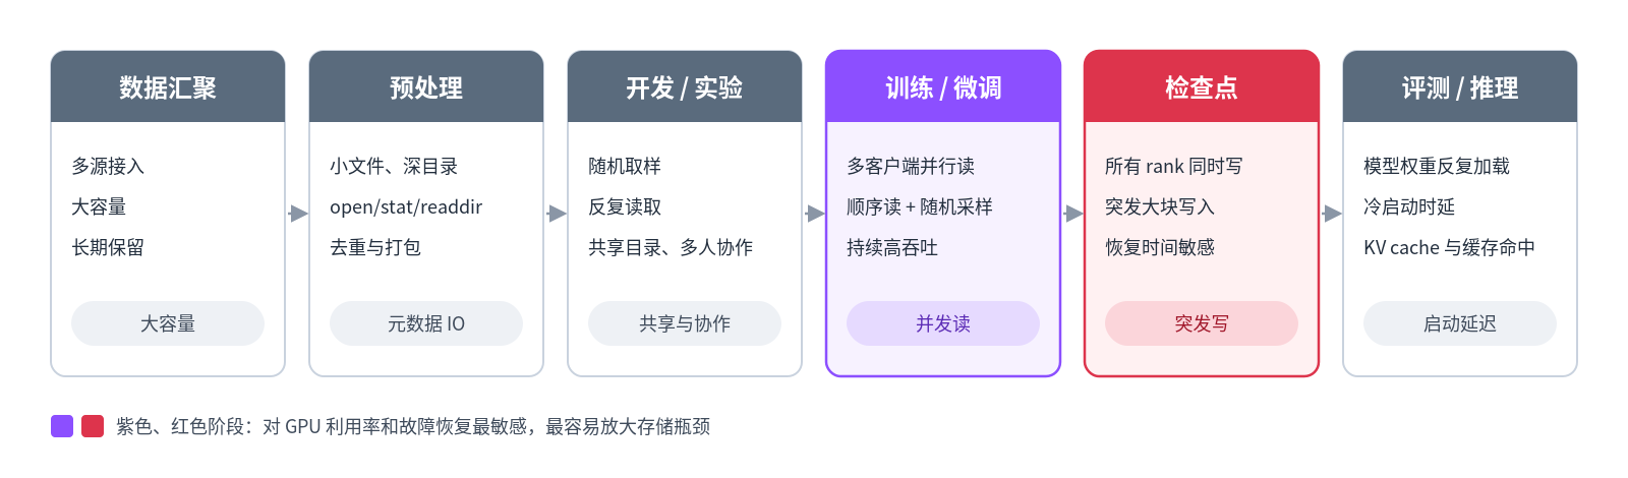
本文从 AI 工作负载各阶段的 I/O 特征出发,对比 Amazon Simple Storage Service(Amazon S3)、Amazo…
IT之家 11 月 11 日消息,华为麒麟官方公众号今日发文,详细介绍了首款「逻辑折叠」技术 τ 芯片 —— 麒麟 9050 系列的新一代达芬奇架构…
智能体式强化学习(RL)与多教师同策略蒸馏(MOPD)为后训练提供了互补的路径。然而对视觉智能体而言,工具使用带来两个相关挑战:模型可能忽视……
对 10 个开放 MoE 模型如何路由 Token 的配置核验式对比:总参数与激活参数、专家数量、top-k、共享专家、门控函数以及负载均衡方法。
MoE 路由策略决定每个 Token 由哪些专家处理。本指南讲解 7 种方法,从 Mixtral 的 top-2 softmax 到 DeepSee…
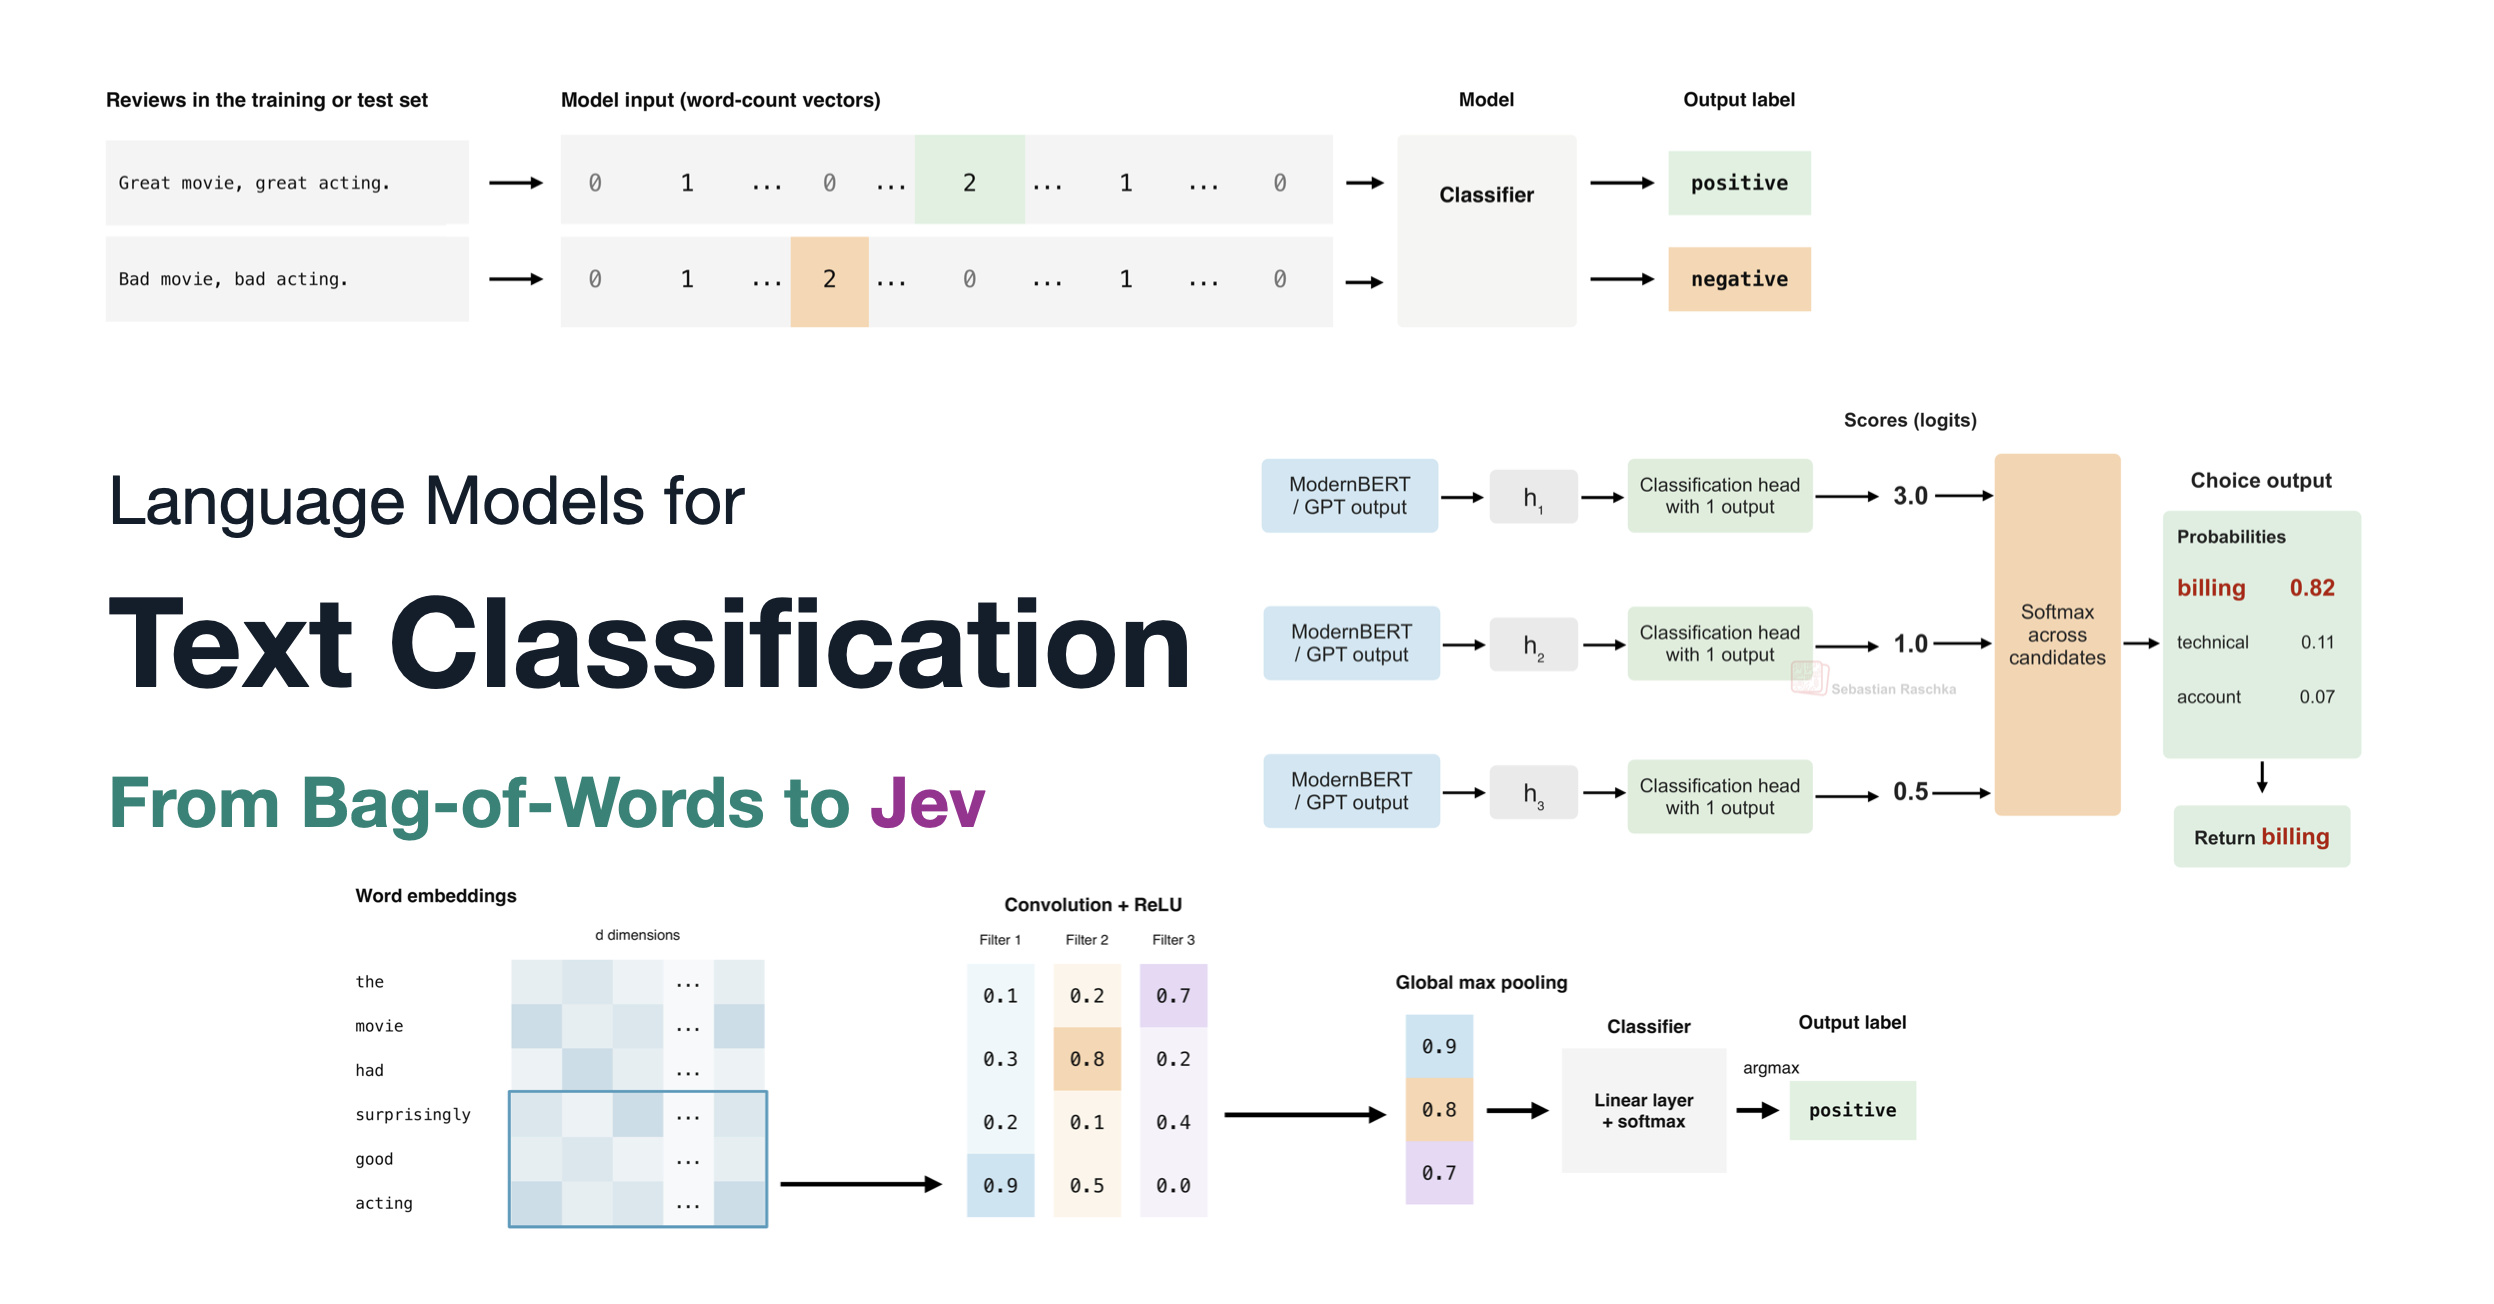
一份图解指南,讲解 RNN、CNN、Transformer 与校准,并附有围绕准确率与效率的实操实验。
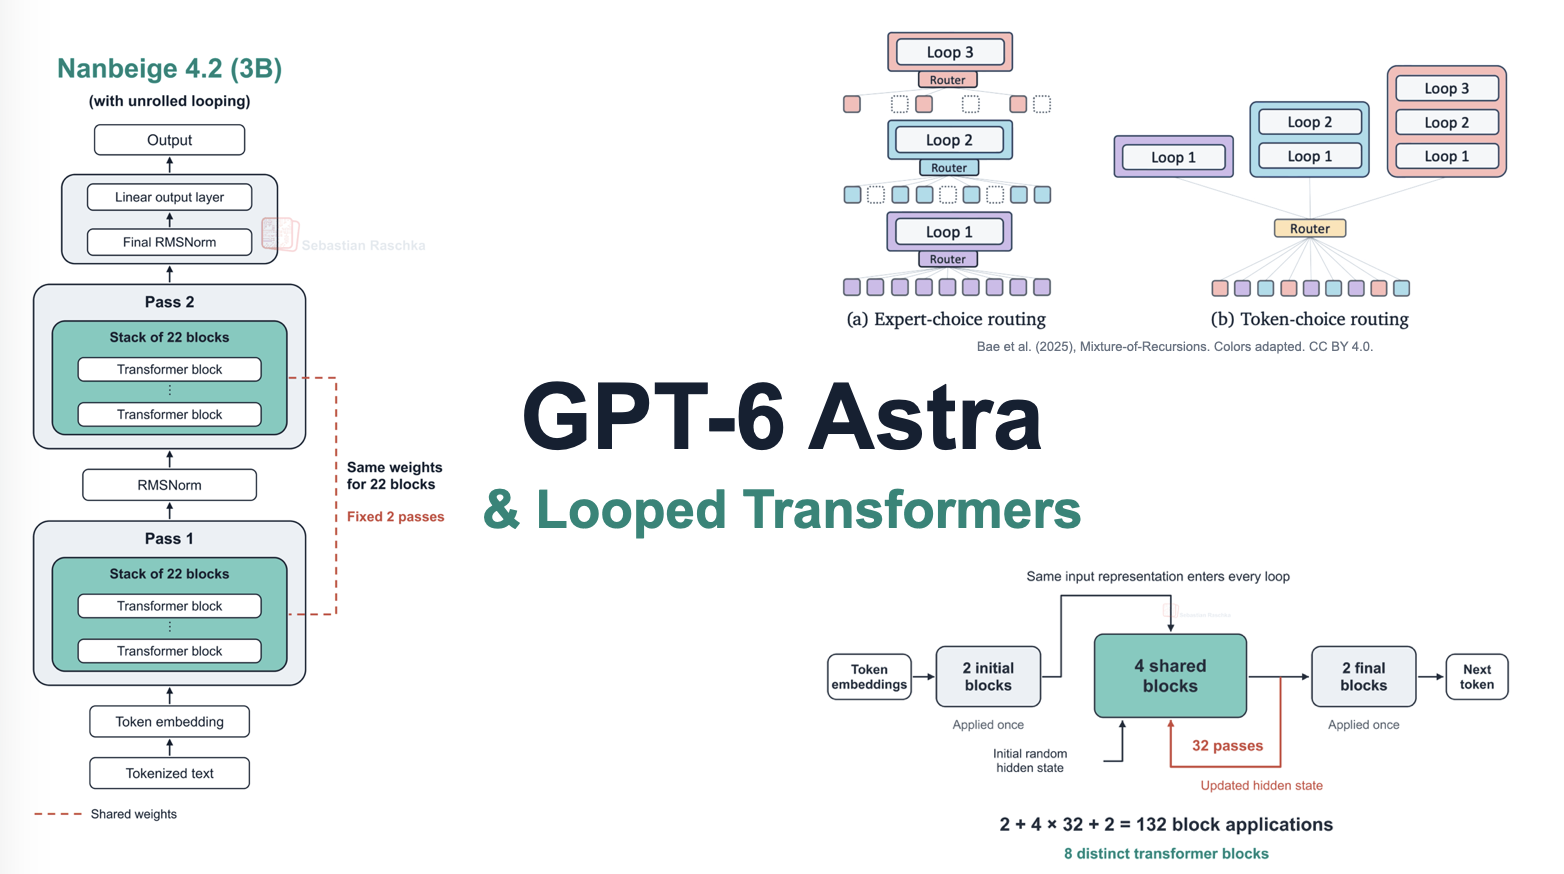
探讨循环深度、隐藏思维链,以及近期围绕 Transformer 循环块的研究。