CanopyKV:超越裁剪区域的记忆实现快速主动视觉推理
主动视觉推理让多模态模型通过迭代式图像检查与工具使用收集细粒度证据,从而回答具有挑战性的视觉问题。然而,不断累积的裁剪图像与推理 Token…
主动视觉推理让多模态模型通过迭代式图像检查与工具使用收集细粒度证据,从而回答具有挑战性的视觉问题。然而,不断累积的裁剪图像与推理 Token…
商汤科技周二发布了 SenseNova Loop-9B 的权重与代码,这是一个多模态模型,通过让部分层运行不止一次来提升计算深度。这个约 90 亿参…

OpenAI 发布 GPT-6.2 Astra 和 Sol,强化编程、电脑操作与专业工作 OpenAI 正式发布 GPT-6.2 Astra 和 G…
人类的认知状态(如分心、压力)、注视与行为,会以微妙的方式与驾驶环境相互作用,AI 可借此辅助驾驶员,但人类认知状态水平的真实标签…
人脸伪造检测方法在已知篡改类型上通常表现良好,但对未见过的篡改泛化能力很差。多模态大语言模型(MLLM)能够识别人脸部位并评估其视觉合理性。现有……
建筑级野火脆弱性评估对于减少野地-城市交界带社区的损失至关重要,但现有方法往往无法将地块尺度的引燃路径与社区尺度的地理……结合起来。
是石科技最新发布多模态模型服务
多模态持续指令微调要求多模态大语言模型依次获得新能力,同时不发生灾难性遗忘。混合专家(MoE)架构提供了一条有前景的途径……
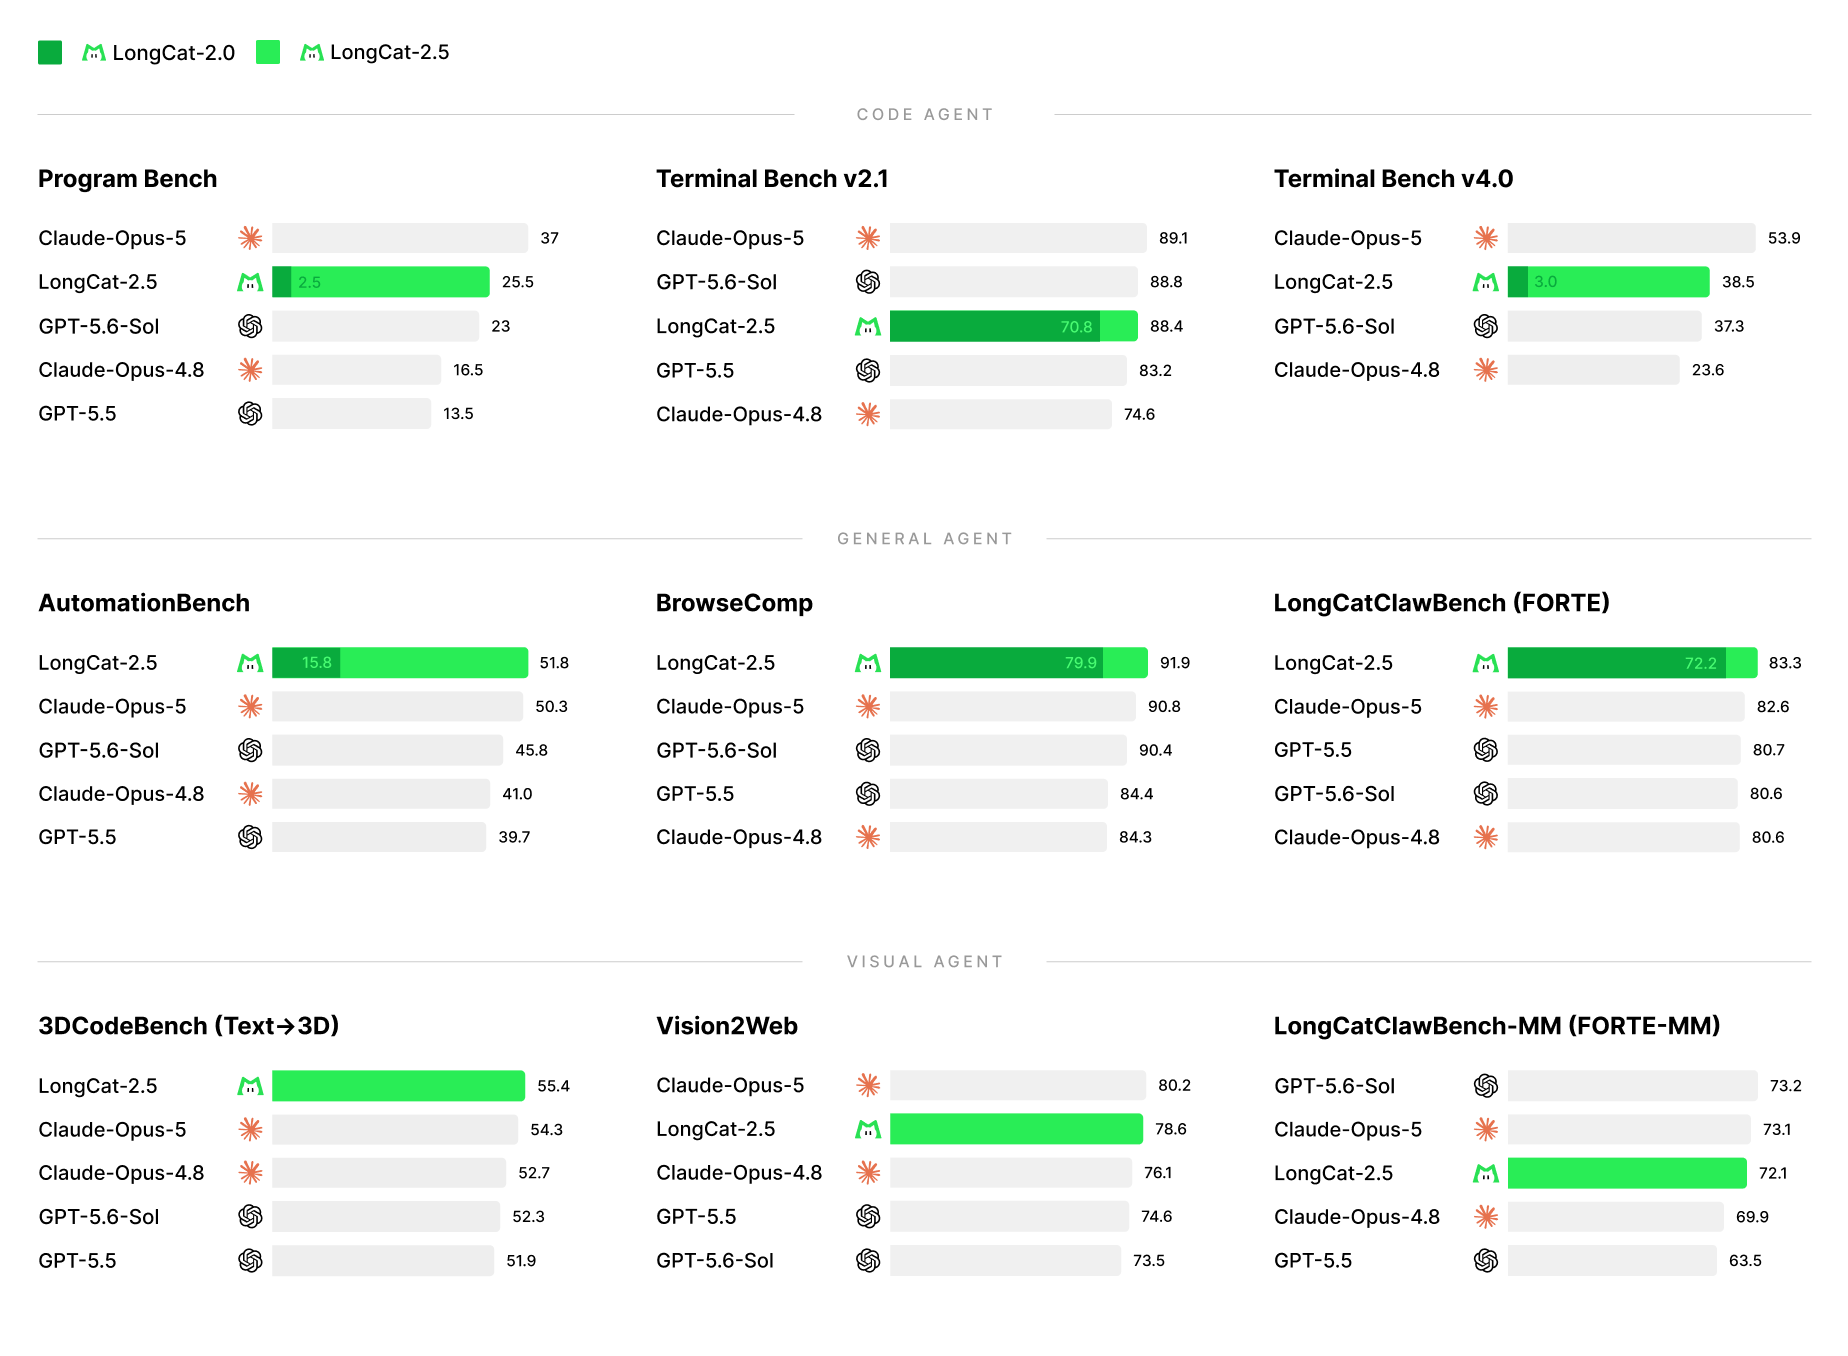
美团发布 LongCat-2.5,一个面向长程智能体任务的原生多模态模型。模型总参数量为 1.6 万亿,每个 token 激活约 480 亿参数,在…
多模态语言模型应如何编码视觉输入仍存争议。多数模型使用预训练的视觉编码器,而近期一些方案则与语言模型一起从零训练编码器,或干脆将其去掉……
「CAD拆解」

认识 Gemini Decisions API,它由我们最先进的模型 Gemini Decision 驱动,可快速做出经过校准的多模态决策。
推理视觉语言模型(VLM)因庞大的多模态上下文和不断增长的推理轨迹而面临巨大的 KV 缓存需求。低秩 KV 压缩已成为一种有前景的范式,它存储低维……
医学大型多模态模型(LMM)的最新进展为临床决策支持带来了可期的进步,但幻觉——即生成看似确信却在临床上无法验证的输出——构成了关键……
Gemini 4 标志旁标注着文字“Visual Knowledge Work”,并配有文档插图

多模态大语言模型(MLLM)能够整合跨模态信息,但当各模态彼此不一致时会变得不可靠。在输入冲突的情况下,MLLM 可能偏向并非最可靠的模态……
常驻智能体正承担更长、更复杂的企业工作流。单个请求可能涉及阅读文档、跨来源核对信息,……

腾讯混元跻身最强开源模型!一手实测Hy4:搭配WorkBuddy,多模态Agent交付力拉满
Nature Machine Intelligence 于 2026 年 11 月 9 日在线发表;doi:10.1038/s42256-026-0…
发言人:高通公司AI产品技术中国区负责人 万卫星 2026年11月7日,上海 终端侧AI发展到了什么阶段? 终端侧AI经过过去3至4年的发展,正在迎…
虚拟现实(VR)体验常利用丰富且具空间感的多模态环境来提升沉浸感与参与度。这要求对视听刺激具有一致的空间感知,因为感知到的差…
蚂蚁集团于 11 月 5 日发布 Ling-3.2-flash,新增原生多模态模型,可接受文本、图像和视频。该模型总参数为 5600 亿,每次推理激…

IT之家 11 月 6 日消息,蚂蚁百灵官方团队今日宣布推出原生多模态模型 Ling-3.2-flash,拥有 560B 总参数、25B 激活参数、…

腾讯发布了 Hy4,这是其首个既能理解图像、又能自行操作软件的多模态语言模型。在 Artificial Analysis 智能指数上,它得分 35…
来自 Cloudflare 的 27B 多模态决策模型 Clef 现已上线 Ollama,可在本地或 Ollama 云端运行。