面向编程智能体的外部沙箱
面向编程智能体的外部沙箱 我一直在探索对智能体所执行的代码进行沙箱隔离的新方式,重点在于让试用本地模型变得更安全,无需担心一次失误或提示注入会……

大模型从架构到上线的实现路径:框架怎么选、模型怎么部署、Token 怎么省、厂商怎么做。
选模型与精度,实时拆解权重 / KV Cache / 框架开销,并给出可落地卡型与卡数
口径:工具为资料库同名页面的站内副本(发布版本 15,数据更新 2026-11-09),测算含权重冗余、KV Cache、框架开销与 5% 安全余量,结果为选型参考,实际以压测为准。价格为该工具自带口径(人民币含税渠道价 / 美区按需折算),与本频道下方「部署速查」和算力频道的价格表分开阅读,不可互相推算。上游更新后重跑 tools/sync_vram_tool.py 同步,版本号随之变化,浏览器缓存自动失效。
多数团队先用 vLLM 起步,压测后再按吞吐或国产化要求换引擎
| 引擎 | 关键机制 | 量化与并行 | 硬件平台 | 选型提示 |
|---|---|---|---|---|
| vLLM通用开源首选 | PagedAttention 分页 KV、连续批处理、前缀缓存 | AWQ / GPTQ / FP8;TP、PP 并行 | NVIDIA / AMD / 昇腾(社区版) | 生态最广、特性跟进快,生产环境锁版本 |
| SGLang高并发与多轮对话 | RadixAttention 前缀树复用、约束解码 | 与 vLLM 主流量化基本一致;TP | NVIDIA / AMD | 前缀命中收益取决于请求相似度 |
| TensorRT-LLM固定模型追极致吞吐 | 编译期图优化、In-flight Batching | FP8 / FP4(按架构);按卡型编译 | NVIDIA | 与驱动、CUDA、TRT 版本强绑定,升级要重建 engine |
| LMDeploy国产开源模型适配快 | TurboMind 引擎、KV 量化 | AWQ / INT4 KV | NVIDIA | 新模型支持跟进快,覆盖面不及 vLLM |
| llama.cpp / Ollama单机、边缘、个人 | GGUF 量化、CPU/GPU 混合卸载 | Q2–Q8 GGUF | CPU / Apple Silicon / 消费卡 | 并发弱,不适合多租户生产 |
| MindIE昇腾原生栈 | CANN + ATB 算子、连续批处理 | 昇腾量化(W8A8 等) | 昇腾 910B / 910C / 950 系列 | 模型需完成算子适配,交付前逐项验证 |
卡型RTX 4090 24GB / L40S 48GB
模型8B–32B,INT4/AWQ
引擎Ollama 起步,转 vLLM
约束并发与长上下文先到瓶颈
卡型H20 96GB / 昇腾 950PR 112GB
模型70B FP8 或百 B 级 MoE
引擎vLLM / SGLang / TensorRT-LLM
约束要 NVLink 或 PCIe 4.0 x16,看 TTFT 与故障域
卡型昇腾 910C 128GB / 910B 64GB
模型同参数档国产开源模型
引擎MindIE + CANN
约束算子覆盖与模型迁移成本先评估
面向编程智能体的外部沙箱 我一直在探索对智能体所执行的代码进行沙箱隔离的新方式,重点在于让试用本地模型变得更安全,无需担心一次失误或提示注入会……
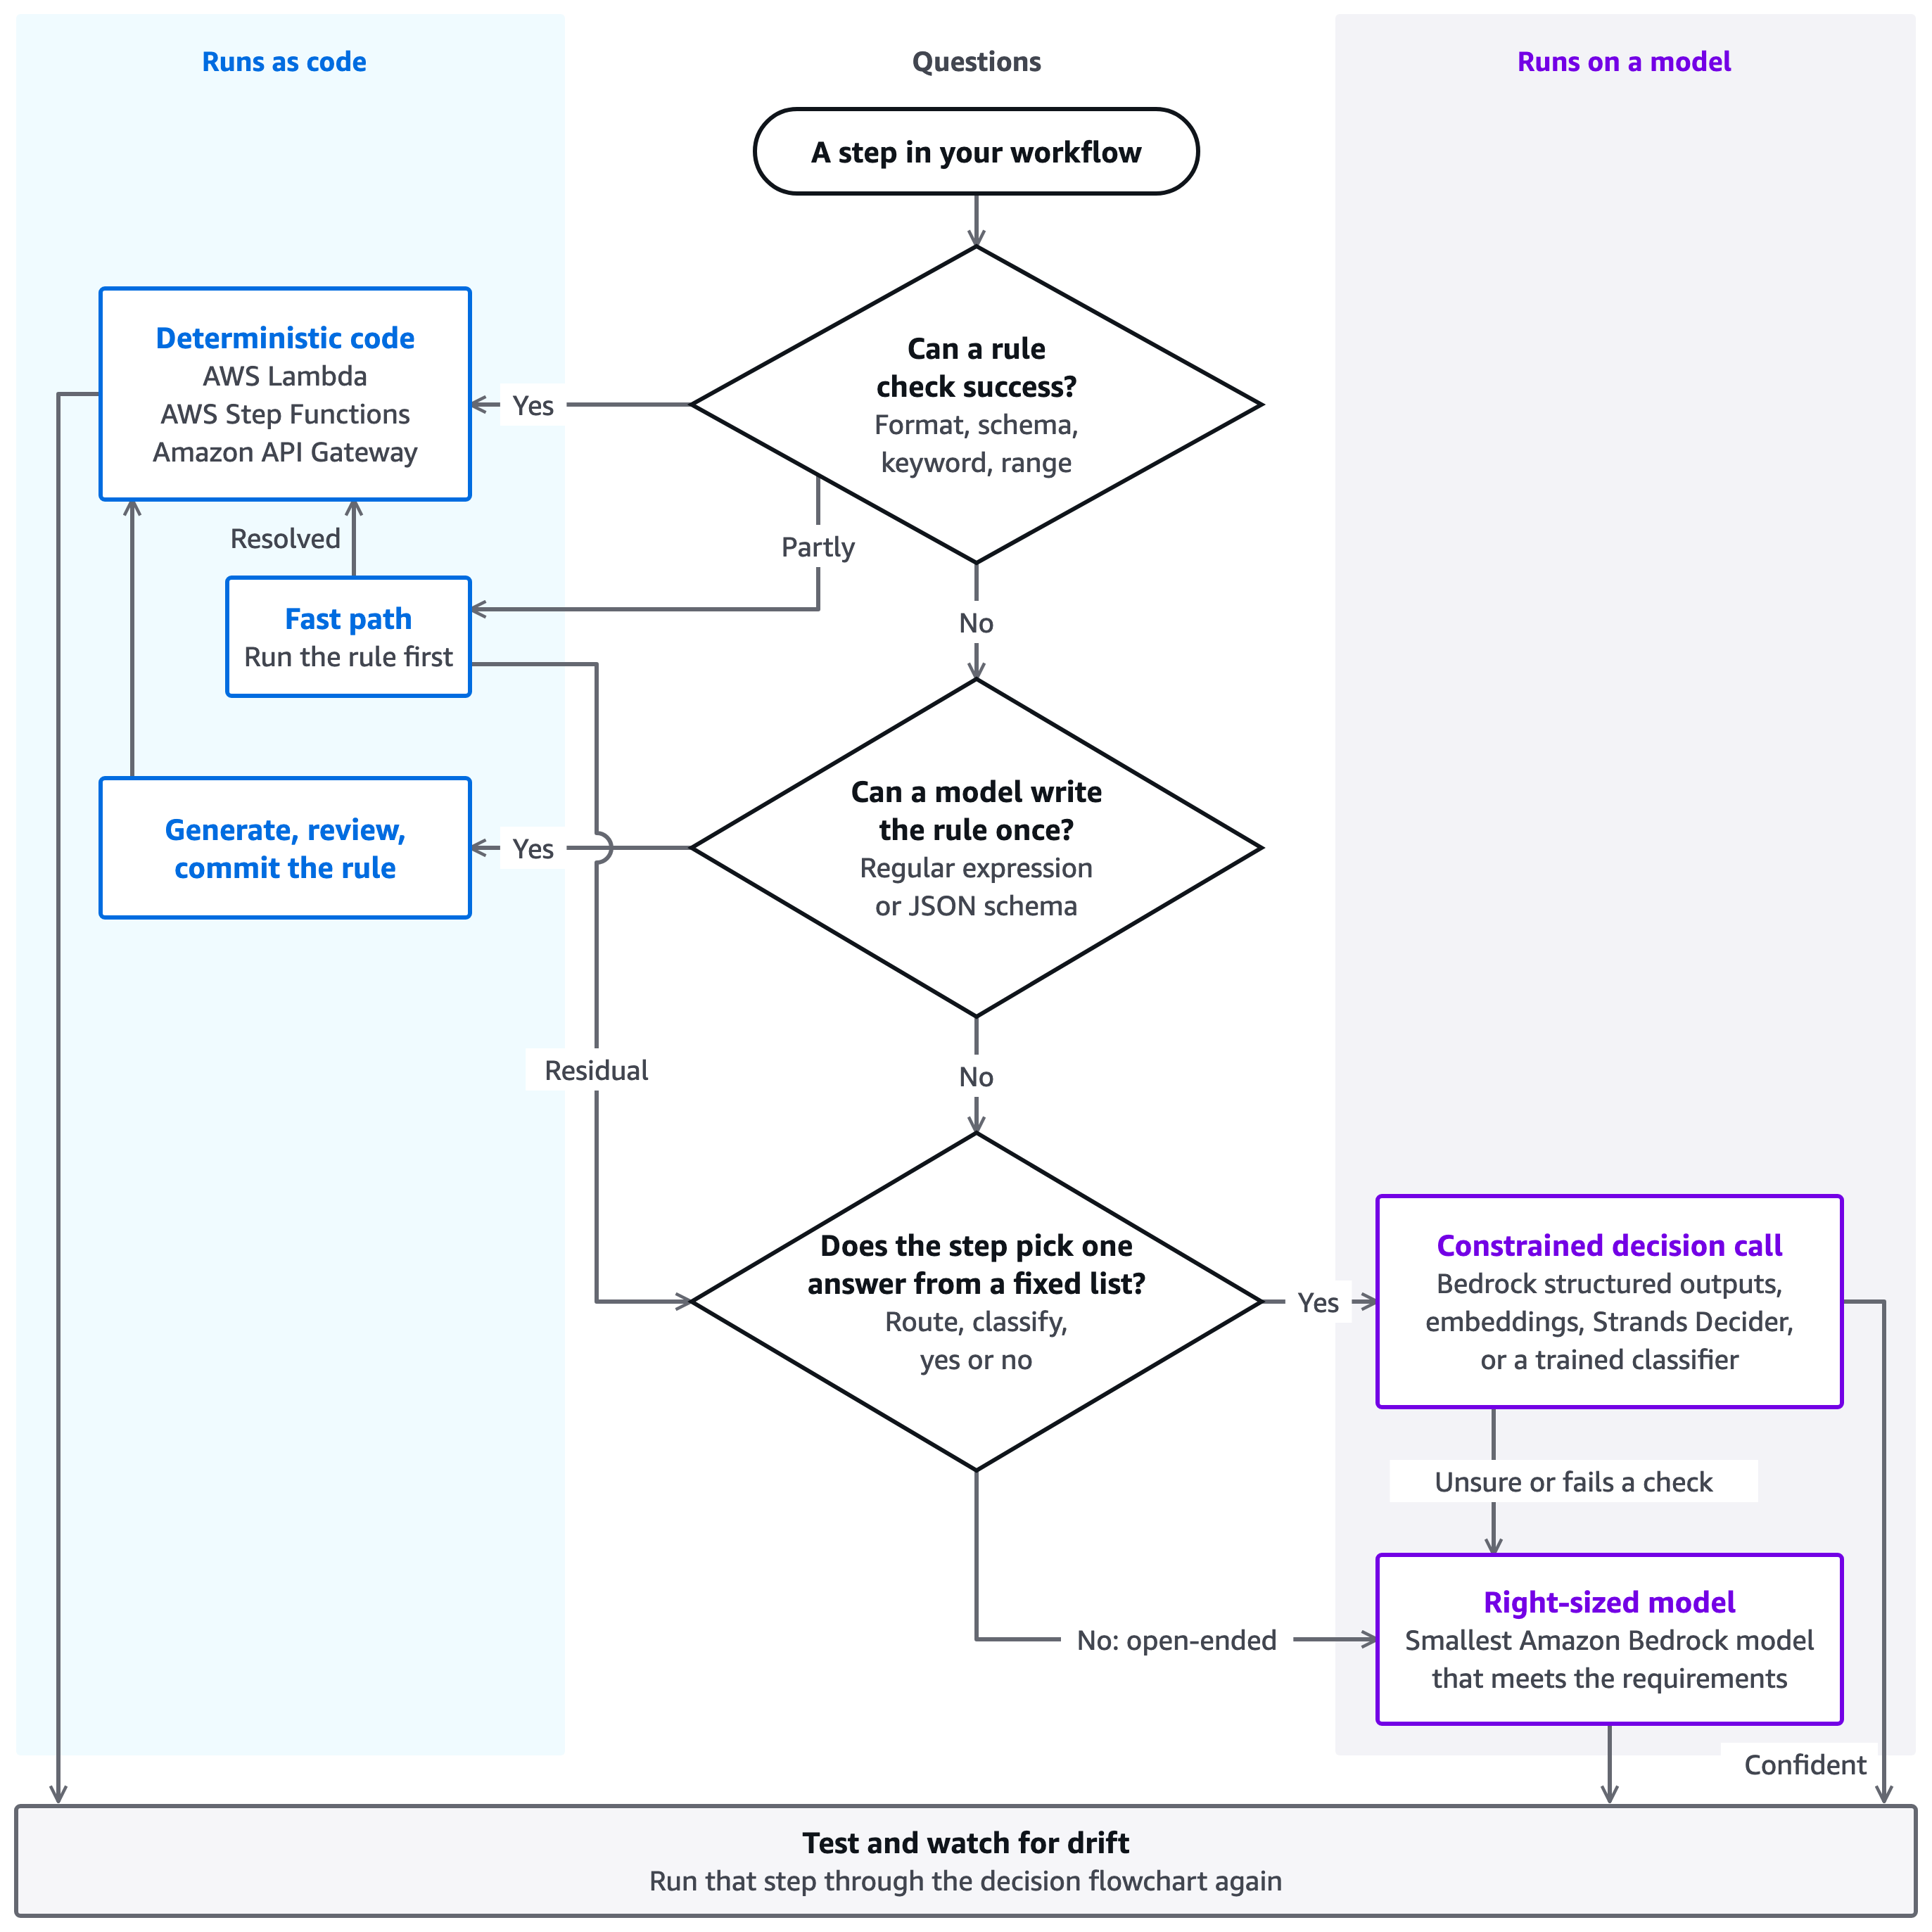
生成式 AI 系统中最大的成本杠杆,在于你到底要不要调用模型。了解如何判断每个工作流环节是否真的需要模型,并把每种选择对应到 AWS:确定性代码、受…
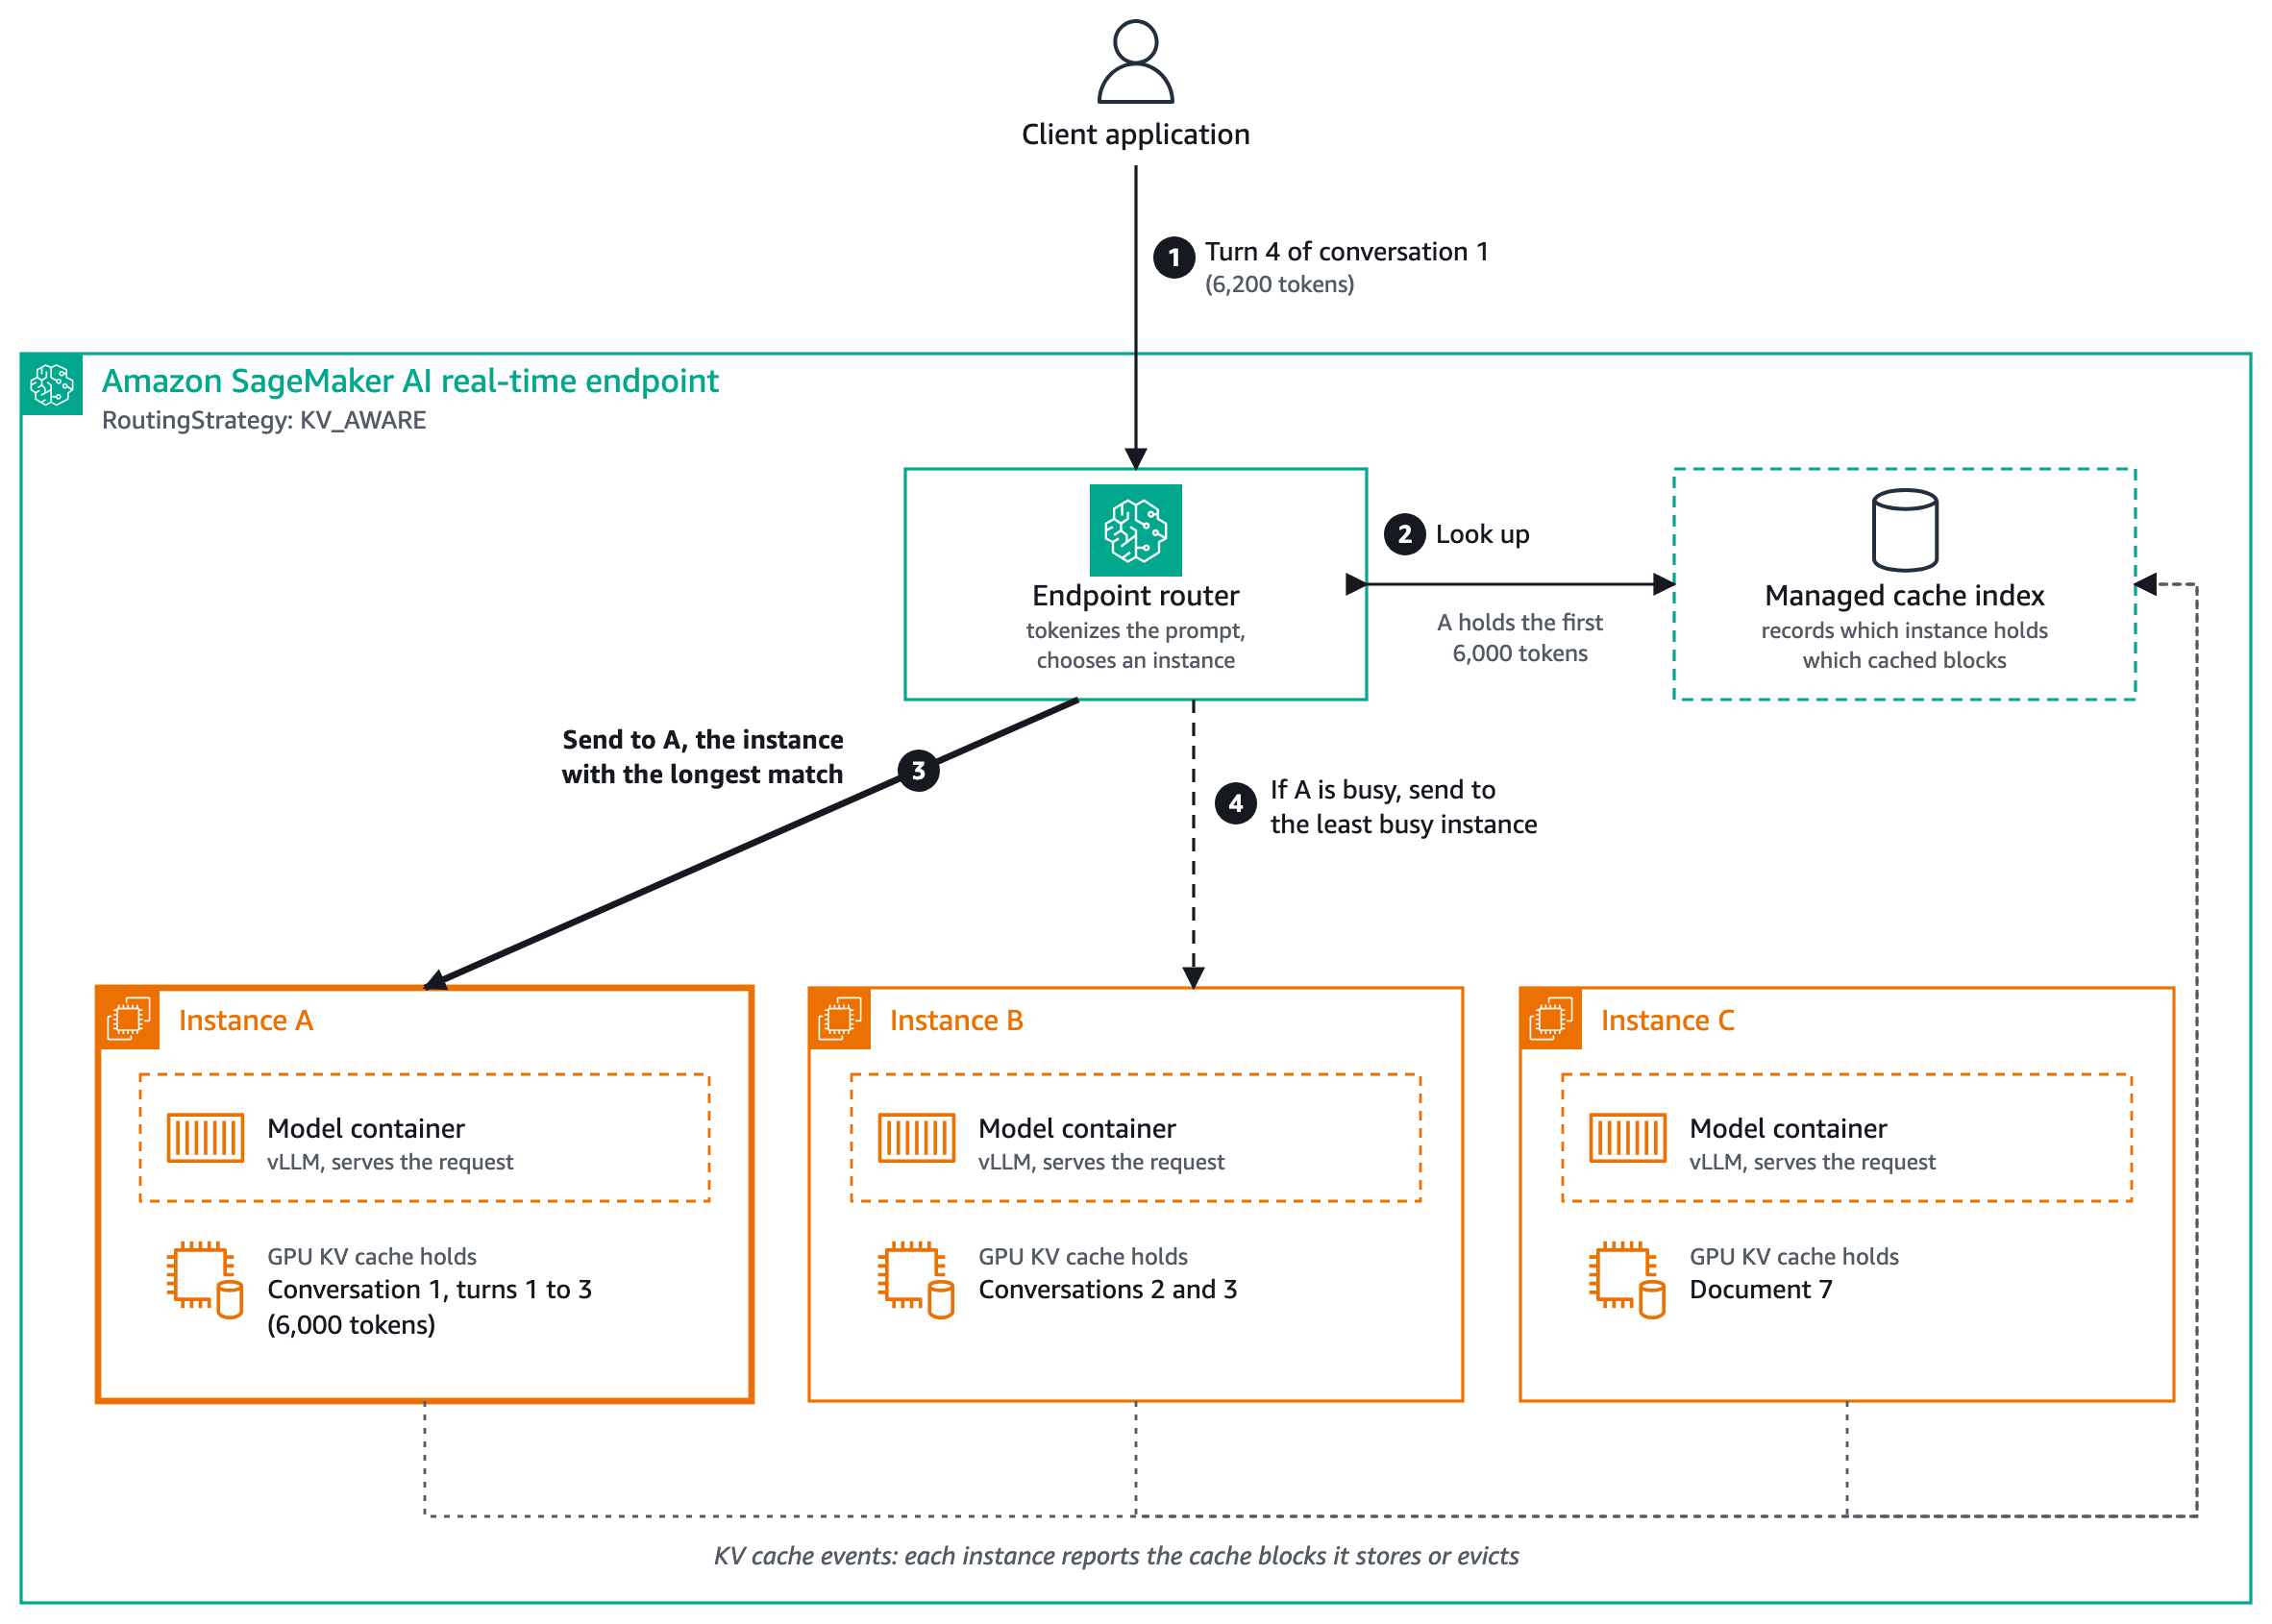
Amazon SageMaker AI 实时端点现支持 KV 缓存感知路由,这一新策略会把每个请求路由到缓存中持有其提示词最长匹配的实例上。了解它的…
为防止 AI 开发工作流耗尽开发者机器的资源,Shopify 构建了 Remote Dev——一个远程移动开发环境,让 AI 智能体能够独立构建、测…
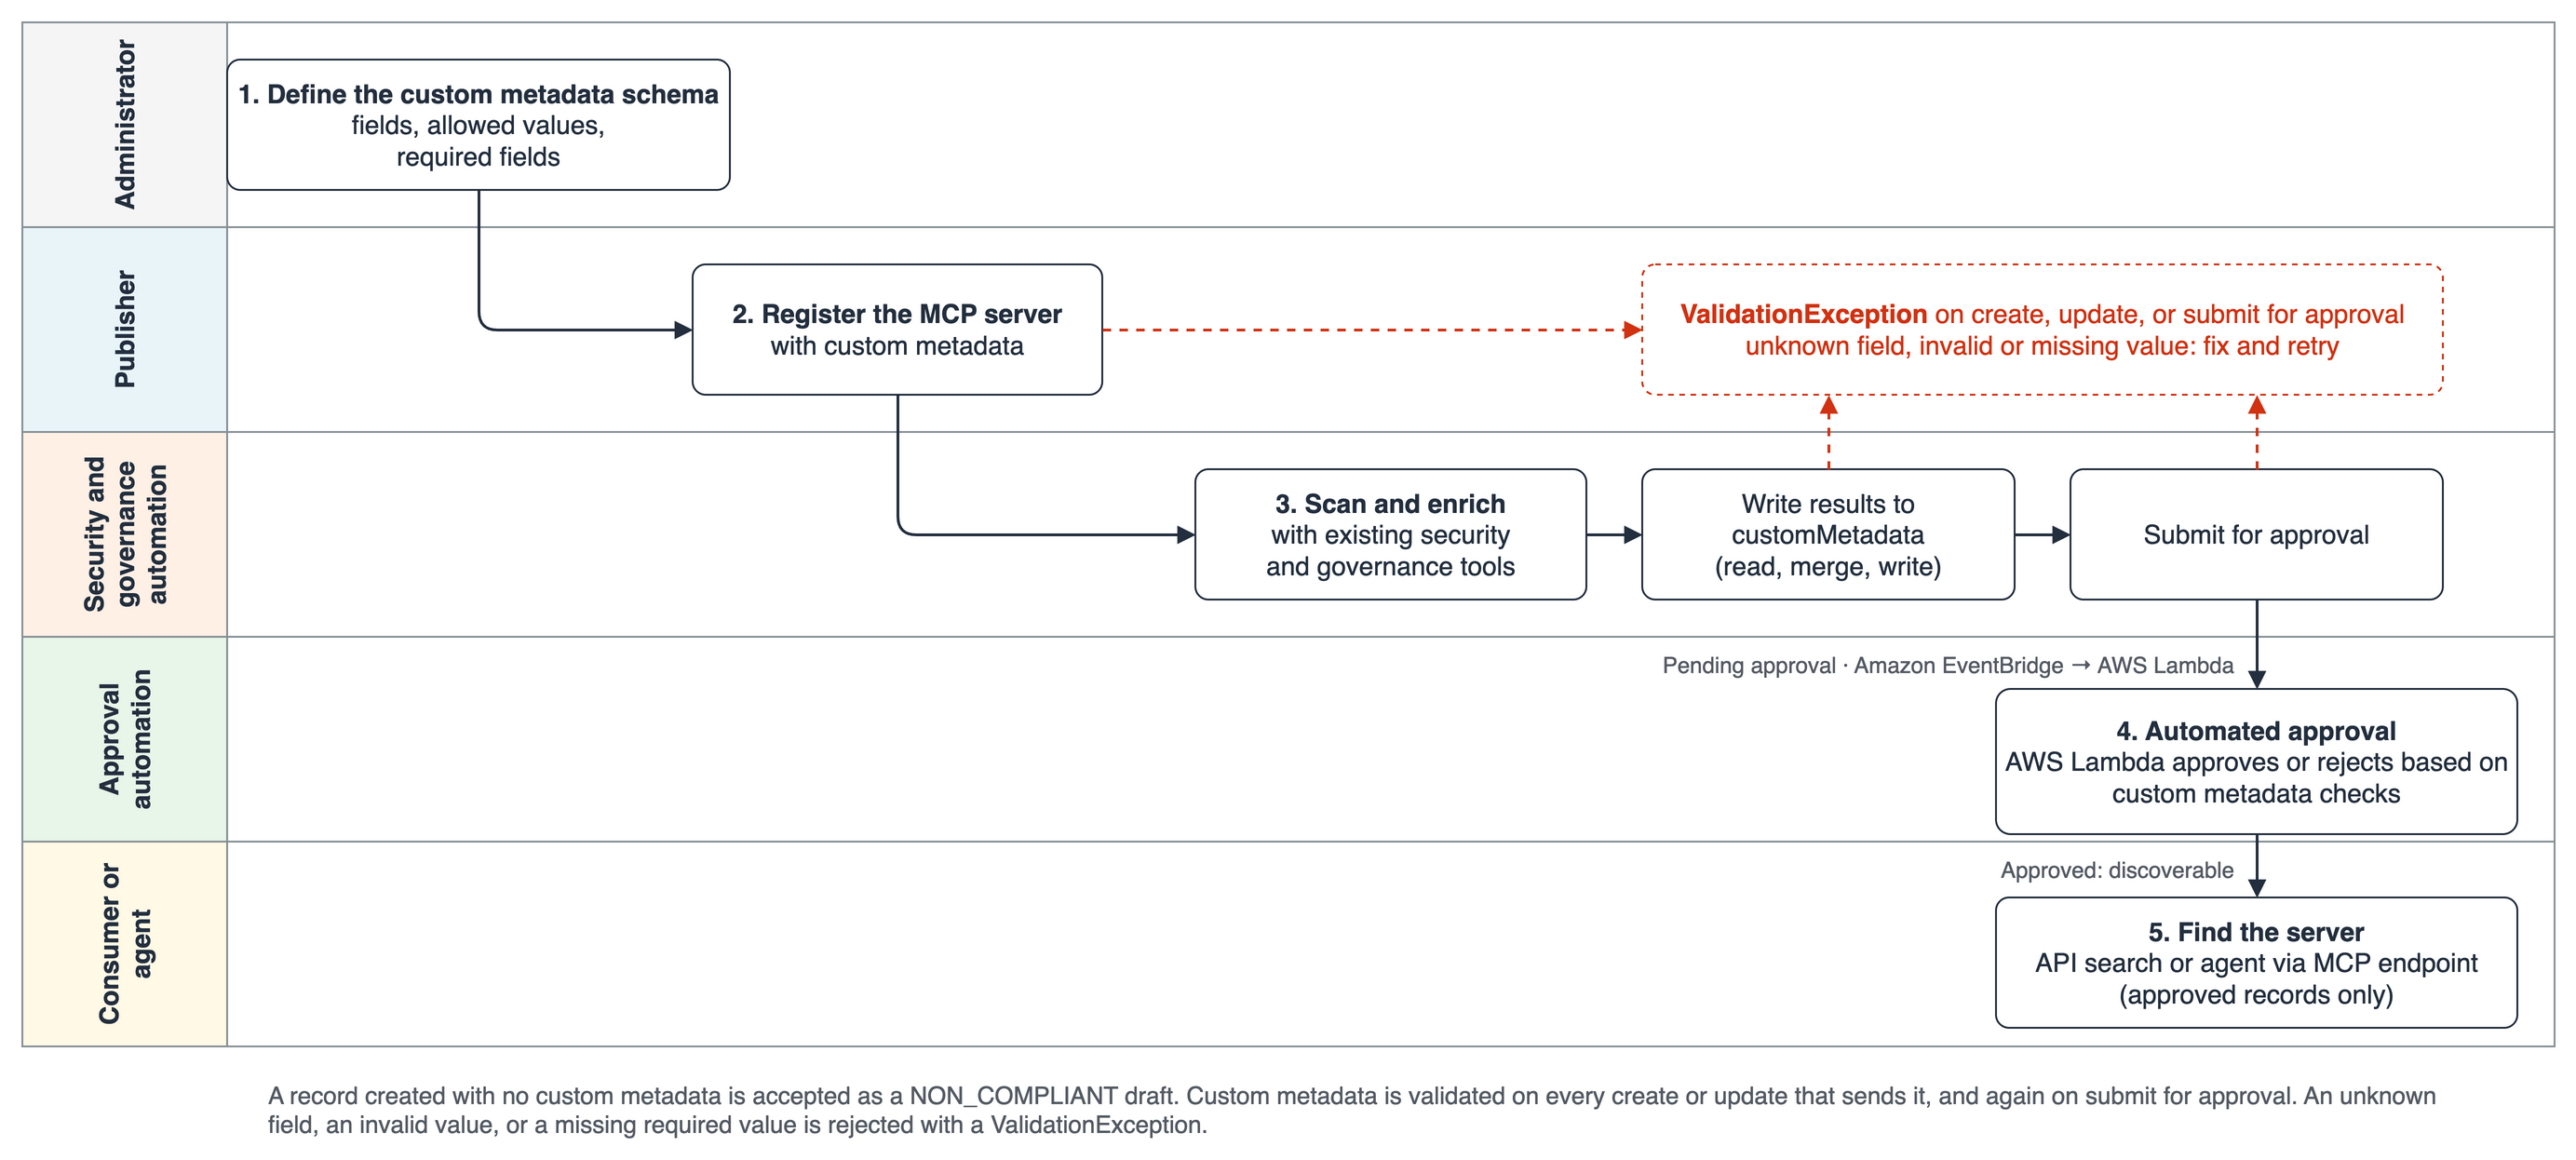
AWS Agent Registry 中的自定义元数据架构允许管理员定义带类型、经校验的字段,每个智能体、MCP 服务器和技能都必须携带这些字段。本…
Quad9 被迫退出法国,凸显出强制实施 DNS 层面封锁的危险。我们探讨为何迫使公共解析器充当内容过滤器在技术上存在缺陷,并威胁开放的互联网。

训练下一代机器学习原子间势(MLIP)需要真值:数千万到数亿次密度泛函理论(DFT)……

多数企业的 AI 能在演示中跑通,却在投入生产前停滞。AWS Forward Deployed Engineering 弥合了这一缺口。AWS 工程…
Databricks 黑客松如何运作——我们举办这些黑客松的原因很简单:最快的……

为自回归语言模型收集大规模、多样且高质量的后训练数据集颇具挑战。因此,监督微调(SFT)通常只能应用于规模显著更小的数据集……
为自回归语言模型收集大规模、多样且高质量的后训练数据集颇具挑战。因此,监督微调(SFT)通常只能应用于规模远小于此的数据集……
视觉无障碍智能体、机器人等应用,需要在有限的过去帧窗口(例如最近两分钟)内,及时回答关于近期视频内容的问题。混合视觉语言模型……