播客:llm-d、Wasm 与 TornadoVM 的分布式 LLM 推理
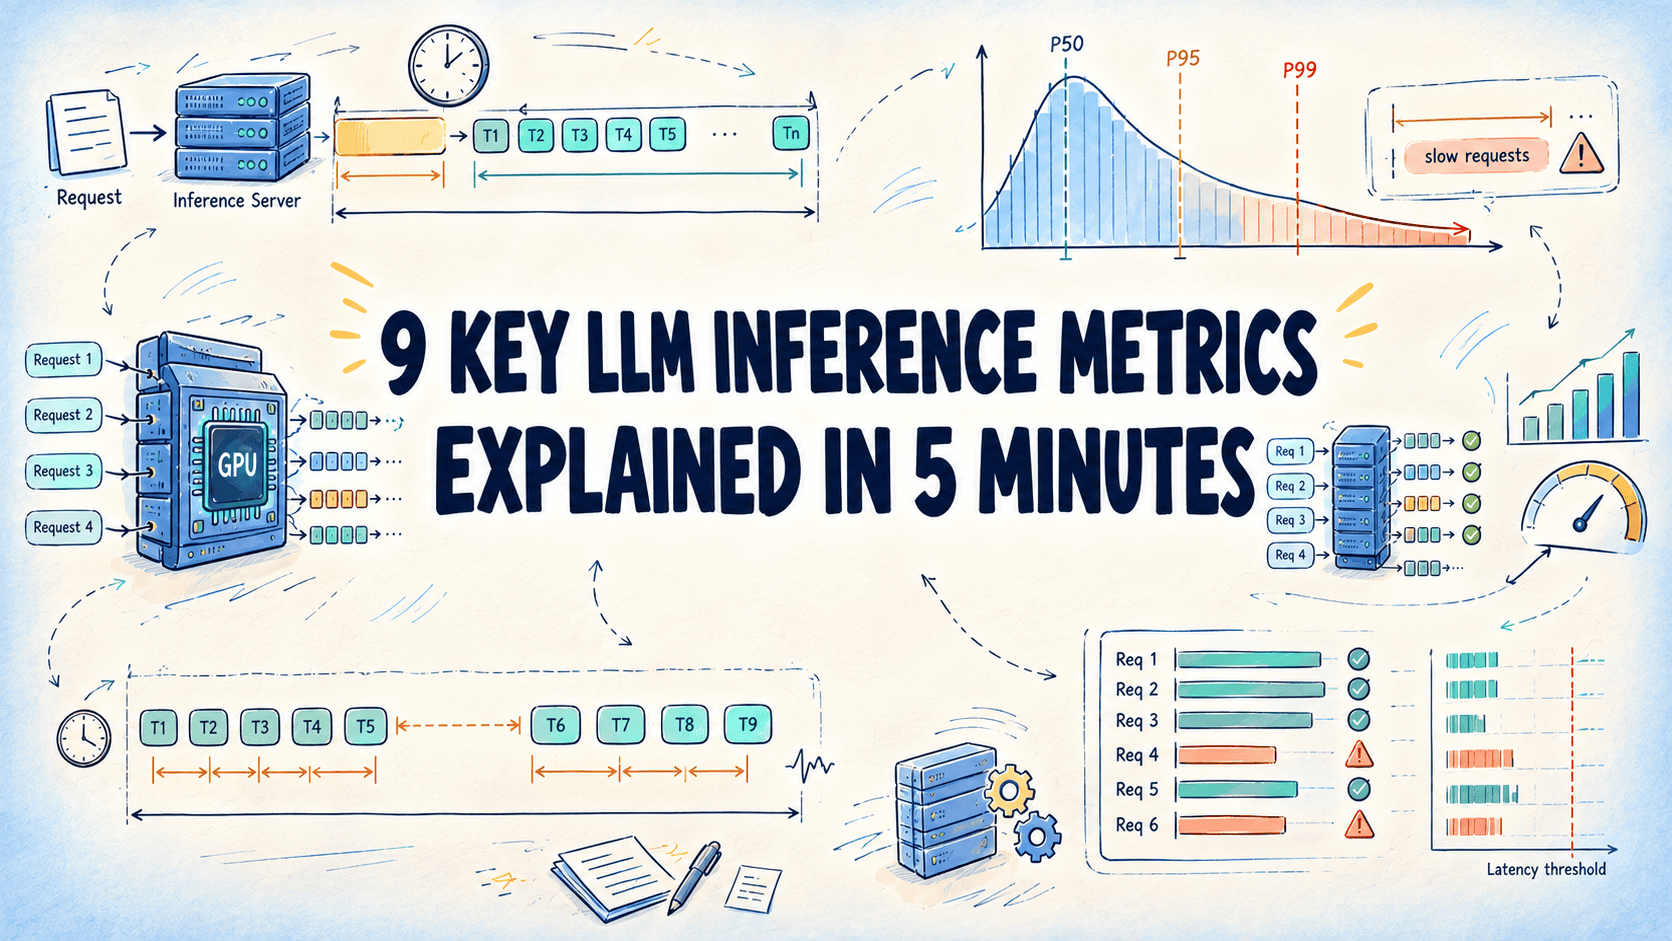
在本期节目中,Edoardo Vacchi 探讨了 WebAssembly 在后端不断演进的格局、使用 TornadoVM 在 GPU 上运行 Java 工作负载,以及利用 llm-d 和 vLLM 在 Kubernetes 上优化分布式 AI 推理。
原文为英文,标题与摘要由机器翻译,完整内容请阅读原文。
本文为自动采集的摘要速览
全文正在由采集器补抓,稍后刷新本页即可看到完整译文;也可先前往来源站点阅读原文。
本文由采集器自动同步
阅读原文 ↗
原文发布于 InfoQ(Podcast: Distributed LLM Inference on Kubernetes with llm-d, Wasm, & TornadoVM),标题、摘要与正文由机器翻译,术语按行业惯例统一,未经人工逐句校订。