AI 训练与推理场景下 AWS 存储服务选型实践
摘要:本文从 AI 工作负载各阶段的 I/O 特征出发,对比 Amazon Simple Storage Service(Amazon S3)、Amazon Elastic File System(Amazon EFS)和 Amazon FSx for Lustre 在性能、VPC IP 地址消耗、成本、POSIX 语义与配额管理上的差异,并给出分层参考架构和选型方法。核心思路只有一条:按数据的访问特征分层,让每一类数据落在最合适的存储上。
目录
一、引言
1.1 背景
GPU 是训练集群里最贵的资源,但它常常要停下来等存储:训练时等数据读进来,保存检查点(checkpoint)时等数据写完;到了推理扩容,新节点光是加载模型权重就要好几分钟。
随着模型和集群规模不断扩大,存储要同时应对几类相互冲突的需求:训练时上千个客户端并发读取,保存检查点时在短时间内集中写入,推理扩容时要尽快把模型加载到 GPU,而原始数据还要以较低的成本长期保留。很少有一项存储服务能把这几件事同时做到最好。
在亚马逊云科技上,这类讨论通常围绕 Amazon S3、Amazon EFS 和 Amazon FSx for Lustre 展开。在我们近一年参与的项目实践中,进入最终方案比较的基本都是这三项服务。三者分别是对象存储、全托管的 NFS 文件系统和并行文件系统,语义、性能、计费和运维方式都不一样。只拿峰值带宽来比,很容易选错;需要回到业务场景,对照下文的几个维度逐项判断。
1.2 适用读者与阅读收获
本文面向在亚马逊云科技上构建 AI 训练与推理平台的架构师和工程师。读完本文,您将能够:
- 了解 AI 工作负载中的三类典型 I/O 特征及相应的性能需求;
- 知晓 Amazon S3、Amazon EFS 和 Amazon FSx for Lustre 在性能、访问语义、成本、VPC IP 地址消耗和配额管理方面的差异;
- 参考常见的分层架构,为不同类型的数据选择合适的存储层;
- 按照本文的选型步骤规划存储方案,并通过实测验证。
二、AI 工作负载的 I/O 特征
2.1 各阶段的 I/O 特征
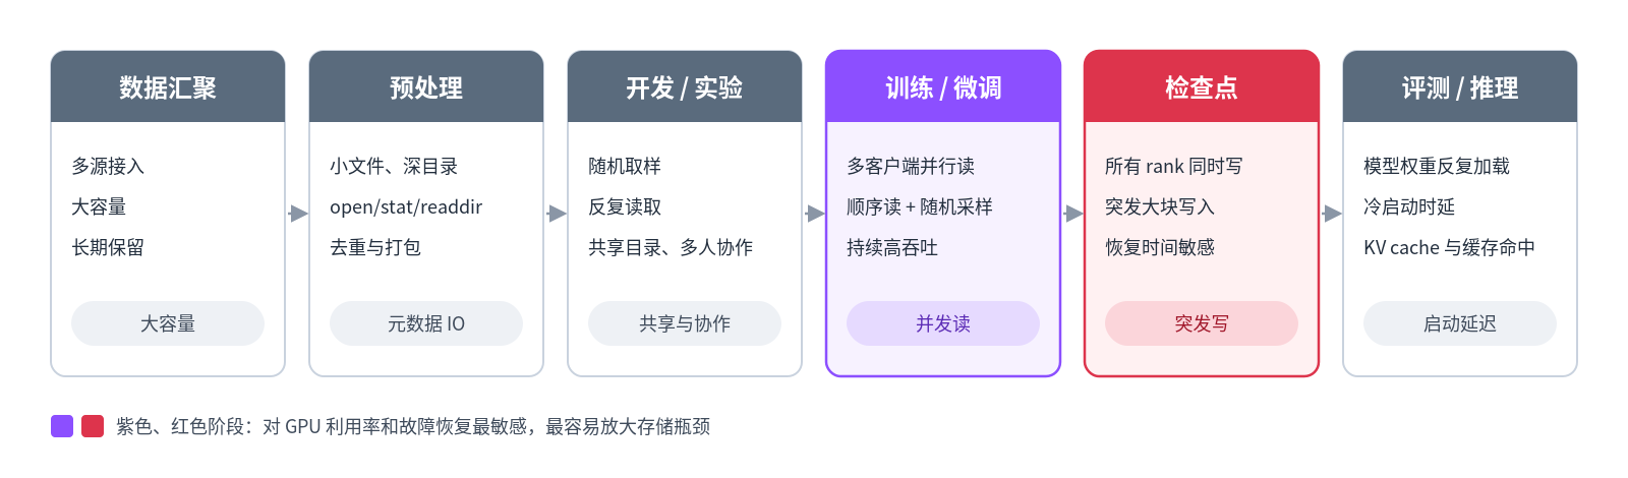
从数据进入平台,到模型训练,再到线上推理,存储系统的访问模式会经历几次明显的变化:
| 阶段 | 访问特征 | 主要评估项 | 关注指标 |
| 数据汇聚 | 多数据源(Amazon S3、自建 HDFS、各类云存储等)集中汇聚,容量大、保留周期长 | 容量与长期成本 | 单位容量成本、生命周期管理 |
| 预处理 | 小文件多、目录层级深,需要进行去重与打包 | 元数据操作(open、stat、readdir) | 元数据操作速率、p99 延迟 |
| 开发与实验 | 随机抽样、重复读取、共享目录 | 多人协作与权限隔离 | 访问延迟、易用性 |
| 训练与微调 | 多客户端并行读取,以顺序读为主并伴随随机采样 | 持续吞吐 | 聚合吞吐、单客户端吞吐上限 |
| 检查点 | 所有 rank 同时突发写入 | 写入时长与恢复时长 | 聚合写入吞吐、尾延迟 |
| 评测与推理 | 同一模型权重被反复加载;KV cache 读写 | 冷启动延迟、缓存命中率 | 单节点读取吞吐、扩容时的并发读取 |
| [图 1:AI 工作负载六个阶段的 I/O 特征] |
这六个阶段中,训练和检查点对 GPU 利用率和故障恢复的影响最大,存储上的问题也最容易在这两个阶段被放大。
2.2 三类典型 I/O 特征
对上述各阶段进行归纳,可以得到三类典型的 I/O 特征。
- 小文件与深层目录。 这类负载先撞上的通常是元数据瓶颈:数据总量也许不大,但 open、stat、readdir 的次数非常多。评估时应关注元数据操作速率(ops/s)、p99 延迟和目录热点。与其在存储侧反复调参,不如先把小文件打包成 WebDataset、Parquet 这类大分片格式,这一步的收益通常最大。
- 大分片并行读取。 以顺序读为主,同时伴随随机采样。聚合带宽和单客户端带宽要分开算:文件系统的总带宽够用,单个节点未必分得到足够的份额。评估时需要分别关注总吞吐(GiB/s)、并发客户端数量和客户端的连接模型。
- 检查点突发写入。 所有 rank 在同一时刻开始写入,还要等待 fsync 和后台写出完成。这类负载关心的是保存需要多久、恢复需要多久。
同样是 100 TiB 的数据,按这三种不同的 I/O 特征分别评估,得出的选型结论可能完全不同。所以我们的建议是:先弄清楚业务属于哪一类 I/O 特征,再去比较具体的存储服务。
2.3 性能需求的估算方法
在动手测试之前,可以先用三个简单的公式估算性能门槛。以下示例中的数值均为假设值。
训练读取吞吐 ≈ GPU 数量 × 单卡每秒处理样本数 × 平均样本大小。 以 256 张 GPU、单卡每秒处理 500 个样本、平均样本大小 100 KB 为例,需要约 12.8 GB/s 的持续聚合读取吞吐。
检查点写入吞吐 ≈ 全量训练状态大小 ÷ 可接受的暂停时长。 如果要在 60 秒内写完 2 TB 的训练状态,需要约 33 GB/s 的聚合写入吞吐;换算成 FSx for Lustre PERSISTENT-1000(每 TiB 1,000 MB/s),大约需要 33 TiB 的容量(估算)。如果这个容量远超数据本身所需,可以考虑异步检查点:先把训练状态写入主机内存或本地 NVMe,训练随即继续,再由后台把数据写入共享存储。这样,训练的暂停时长主要取决于写入主机内存或本地 NVMe 的速度,共享存储只需在下一次检查点开始前完成写出(相关实现见 7.2 节)。
推理冷启动时间 ≈ 模型大小 ÷ min(单节点可达吞吐,存储聚合吞吐 ÷ 同时加载模型的节点数)。 以 140 GB 的模型权重为例,按 Amazon EFS 单客户端 1,500 MiB/s 的上限计算,单个节点的加载时间理论上不低于 90 秒左右(估算)。如果 50 个节点同时扩容,总需求会超过 Amazon EFS 单个文件系统的读取吞吐上限(20–60 GiB/s,因区域而异),瓶颈就从单个节点转移到了文件系统的聚合吞吐。实际耗时还会受到反序列化、模型编译等环节的影响。亚马逊云科技在博客 Fast model loading for AI inference on Amazon EKS 中给出过一组实测数据:在 p5.48xlarge 实例上使用 Run:ai Model Streamer 从 Amazon S3 加载 60–200 GiB 的模型,默认配置下需要 80–460 秒,经过参数调优后可以显著缩短。
三、存储选型的评估维度
3.1 基础性能指标
IOPS、吞吐、延迟、成本和可用性是评估存储的五项经典指标。在 AI 场景中,每一项都需要拆得更细一些。
吞吐要分开看聚合吞吐和单客户端吞吐。上千个客户端读取同一份数据集时,文件系统的总带宽和每个节点能分到的带宽是两码事儿。
延迟不能只看平均值。同步训练中,step time 由最慢的那个 rank 决定,因此 p99 延迟往往比平均延迟更能说明问题。
IOPS 要区分数据 IOPS 和元数据 IOPS。在海量小文件场景下,open、stat、readdir 这类元数据操作通常会先于带宽成为瓶颈。
成本要拆成容量、I/O 和网络三部分来看。有些服务连读写都要收费,比如 Amazon EFS 的 Elastic 模式按读写的数据量计费,训练多读一遍数据集,就多付一次读取费(见 5.2 节)。
可用性要关注故障域和维护窗口。一次故障会损失多少 GPU 时间,取决于恢复需要多久,以及距离上一次检查点过去了多久。
3.2 AI 场景的附加考量
在 AI 场景中评估存储服务,除了性能,还有六个问题最好在选型前就有答案:
- 数据形态:是海量小文件还是大分片?压力主要来自元数据还是带宽?
- 并发模型:上千个客户端读取同一份数据时,聚合带宽和单客户端上限分别是多少?
- 突发写入:所有 rank 同时写入检查点时,写入和恢复各需要多长时间?
- 生态集成:与 Amazon Elastic Kubernetes Service(Amazon EKS)的集成程度如何?会占用多少 VPC IP 地址?
- 配额管理:多个团队共用时,能否按用户、组或项目限制存储容量和文件数量?
- 生命周期:数据如何分冷热?能否与 Amazon S3 配合,把预热、导出、归档和释放串成一条完整的流水线?
前三个问题在性能评估中通常都会覆盖到;VPC IP 地址消耗和配额管理则容易被忽略,往往要到平台规模扩大之后才显现出来。第五章会专门讨论这两点,以及成本问题。
四、Amazon S3、Amazon EFS 与 Amazon FSx for Lustre 对比
Amazon Elastic Block Store(Amazon EBS)和实例本地 NVMe 适合用作单节点的临时空间、缓存和本地状态,但无法解决跨节点共享的问题,本文不展开讨论。
4.1 性能与运维特性
下表的数字取自 us-east-1 的公开文档,换了区域、吞吐模式或实例类型,实际表现会有差别。
| 比较项 | Amazon S3 | Amazon EFS | Amazon FSx for Lustre |
| 访问接口 | 对象 API;可通过 Mountpoint for Amazon S3 或 Amazon S3 Connector for PyTorch 以文件方式访问 | NFS v4.1 | Lustre 客户端(POSIX) |
| 创建与扩展 | 秒级;无需预分配容量 | 秒级;容量自动扩展 | 分钟级;需要预置容量和吞吐档位 |
| 聚合吞吐 | 随前缀数量和客户端并发扩展 | 单个文件系统的上限(因区域而异):Elastic 模式读取 20–60 GiB/s、写入 1–5 GiB/s;Provisioned 模式读取 3–10 GiB/s、写入 1–3.33 GiB/s;Bursting 模式读取 3–5 GiB/s、写入 1–3 GiB/s | Persistent 2:每 TiB 125/250/500/1,000 MB/s,随容量线性扩展 |
| 请求速率与单客户端吞吐 | 每个分区前缀每秒至少支持 3,500 次写请求和 5,500 次读请求;单个实例可使用最高 100 Gb/s 的网络带宽 | Elastic 模式下单客户端最高 1,500 MiB/s(需使用 EFS 客户端 v2.0 及以上版本或 EFS CSI 驱动),其他情况下为 500 MiB/s | 未启用 EFA 的文件系统为 100 Gbps;启用 EFA 后为 700 Gbps;结合 GPUDirect Storage 可达 1,200 Gbps |
| 延迟 | S3 Standard 首字节延迟约 100–200 毫秒 | 读取约 1 毫秒,写入约 2.7 毫秒;热点目录会影响 p99 延迟 | 亚毫秒级 |
| 可用性 | 跨多个可用区 | Regional 文件系统跨多个可用区 | 单可用区 |
| 维护 | 无维护窗口 | 无维护窗口 | 需配置 30 分钟的维护窗口;补丁更新期间文件系统会短暂不可用,客户端会自动重试 |
 注意:
Amazon S3 的请求速率不等于文件系统的 IOPS,实际吞吐取决于对象大小和客户端并发。
4.2 访问语义
| 比较项 | Mountpoint for Amazon S3 | Amazon EFS | Amazon FSx for Lustre |
| 定位 | 面向对象存储的高吞吐文件客户端 | 全托管、无需预置容量的 NFS 共享文件系统 | 面向并行训练和 HPC 的并行文件系统 |
| 语义 | 部分文件语义,并非通用 POSIX 文件系统 | NFS v4.1,满足常规共享文件访问需求 | 完整的 POSIX 语义 |
| 写入能力 | 支持顺序写入新文件;启用 –allow-overwrite 后可通过 O_TRUNC 整体覆盖已有文件;不支持随机写入、文件锁和符号链接(重命名和追加写入仅在 S3 Express One Zone 上支持) | 支持常规读写操作和文件锁(建议锁) | 支持常规读写操作和文件锁(挂载时需启用 flock) |
| EKS 集成 | Mountpoint for Amazon S3 CSI 驱动 | Amazon EFS CSI 驱动与 EFS 访问点(Access Point) | Amazon FSx for Lustre CSI 驱动 |
如果业务需要对文件进行原地修改、追加写入或加锁,Mountpoint for Amazon S3 可能无法支持,使用前需要先进行验证。
4.3 Amazon S3 Files
2026 年 4 月正式发布的 Amazon S3 Files 提供了另一种思路:把 S3 通用存储桶直接以 NFS v4.1+ 文件系统的形式提供给计算资源。S3 Files 底层基于 Amazon EFS 构建,活跃数据的访问延迟约为 1 毫秒,采用 close-to-open 一致性,文件系统中的修改会在几分钟内同步回 Amazon S3。如果既需要完整的文件语义,又希望 Amazon S3 仍然是唯一的数据源,可以重点评估这项服务。S3 Files 与 Mountpoint for Amazon S3 在大文件顺序读取和小文件读取上的实测对比,可以参考博客《Mountpoint S3 与 S3 Files 在 EKS 上的实战对比》。
4.4 Amazon S3 Express One Zone
S3 Express One Zone 是 S3 的单可用区高性能存储类:数据放在指定可用区的目录桶中,首字节延迟为个位数毫秒,每个桶默认可承受每秒 20 万次读、10 万次写。它的存储单价约为 S3 Standard 的 4.8 倍(us-east-1 每 GB 每月 0.11 美元,另按读写流量计费),数据也只在一个可用区内冗余,因此适合检查点、小对象数据集、Mountpoint 共享缓存这类容量不大但请求密集的数据,不适合替代 PB 级的数据湖。同一区域内跨可用区访问不收额外的流量费,但延迟会升高,所以选用前要先确认 GPU 所在的可用区(按 AZ ID)在它的支持列表中。
五、存储性能以外的评估维度
5.1 VPC IP 地址消耗
在 Amazon EKS 场景中,存储服务会占用子网中的 IP 地址。消耗来源有两个:一是存储服务自身的网络接口,二是 CSI 驱动中未使用 hostNetwork 的 Pod。不同存储服务的 IP 地址消耗差别很大。
我们以 100 个 GPU 节点为例,分别估算 100 TiB 和 1,000 TiB 两种数据规模下的 IP 地址消耗。估算不包含业务 Pod、节点主 IP 地址和 VPC CNI 预热池(warm pool);Amazon S3 通过网关终端节点(Gateway Endpoint)访问;FSx for Lustre 采用 Persistent 2 部署类型,元数据使用默认的 Automatic 模式。
| 方案 | IP 地址估算公式 | 100 TiB | 1,000 TiB |
| Amazon EFS(3 个可用区均配置挂载目标) | F × A + R | 5 | 5 |
| Mountpoint for Amazon S3 CSI 驱动 v2 | R + N + G + H(+ E) | 201 | 201 |
| FSx for Lustre,启用 EFA,125/250/500/1000 档位 | M + O + R + N | 约 109/112/117/128 | 约 145/172/225/332 |
| FSx for Lustre,未启用 EFA,任意档位 | M + O + R + N | 约 149 | 约 545 |
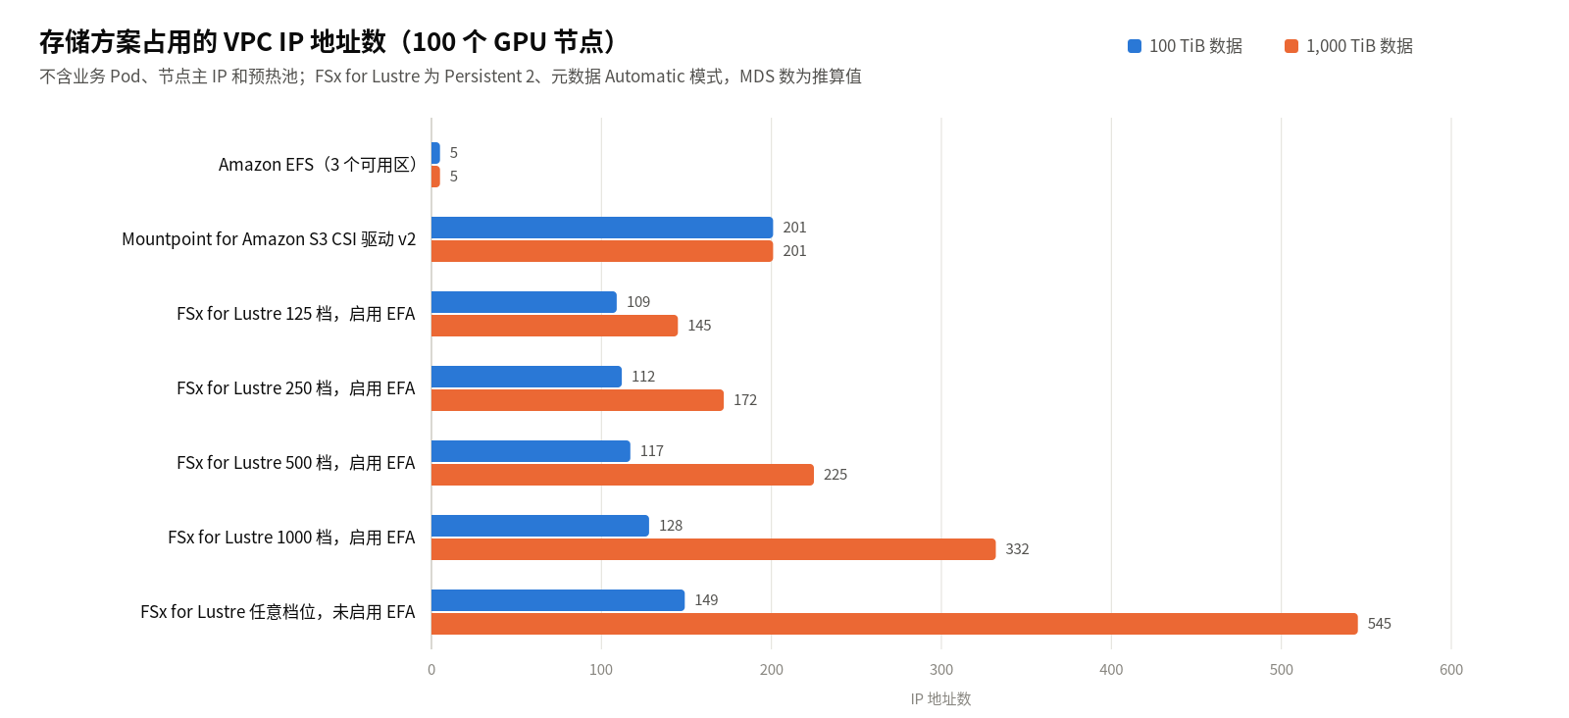 [图 2:存储方案占用的 VPC IP 地址数(100 个 GPU 节点)] |
FSx for Lustre 的 MDS 数为推算值,100 TiB 按 4 个、1,000 TiB 按上限 16 个计算。
公式中的符号含义如下:F 为文件系统数量,A 为配置了挂载目标的可用区数量,R 为 CSI 控制器的副本数,N 为节点数(即 CSI 节点 DaemonSet 的 Pod 数),G 为 Mountpoint Pod 的数量(约等于节点数 × 每个节点上的共享组数),H 为 headroom Pod 数,E 为接口终端节点(Interface Endpoint)数,M 为 Lustre 元数据服务器(MDS)数,O 为 Lustre 对象存储服务器(OSS)数。按 100 个节点计算,Amazon EFS 为 1 × 3 + 2,Mountpoint 为 1 + 100 + 100 + 0;FSx for Lustre 的 R + N 均为 2 + 100,M 和 O 随容量和档位变化,见下文。
Amazon EFS 的 IP 地址消耗基本不随集群规模变化。EFS CSI 驱动的节点 DaemonSet 使用 hostNetwork,不占用 Pod IP 地址;真正占用 IP 地址的只有各可用区的挂载目标(mount target)和默认 2 个副本的控制器。
Mountpoint for Amazon S3 的 IP 地址消耗随 Mountpoint Pod 的数量增长。CSI 驱动 v2 会在每个节点上为工作负载创建 Mountpoint Pod。只有位于同一节点、使用同一 PV、挂载参数相同、认证来源相同且 fsGroup 也相同的工作负载,才能共用一个 Mountpoint Pod;使用 Pod 级身份认证时,还要求命名空间、ServiceAccount 和 IAM 角色都相同。一个工作负载如果挂载了两个不同的 PV,就会分属两个共享组。因此,节点越多、每个节点上挂载的 PV 越多,占用的 IP 地址就越多。
FSx for Lustre 的 IP 地址消耗取决于容量、吞吐档位以及是否启用 EFA。服务端的每个 MDS 和每个 OSS 各占用一个 IP 地址:
- OSS 数量:启用 Elastic Fabric Adapter(EFA)时,125/250/500/1000 档位下每个 OSS 分别对应 38.4/19.2/9.6/4.8 TiB 容量,档位越高,同样的容量需要的 OSS 越多。100 TiB 时分别需要 3/6/11/22 个 OSS,1,000 TiB 时分别需要 27/54/107/214 个。未启用 EFA 时,每个 OSS 只对应 2.4 TiB,100 TiB 需要 43 个 OSS,1,000 TiB 需要 427 个。
- MDS 数量:在 Automatic 模式下,容量达到 48,000 GiB 后,每 24,000 GiB 配置 12,000 元数据 IOPS,每 12,000 IOPS 对应一个 MDS,所以 100 TiB 左右的文件系统大约有 4–5 个 MDS。元数据 IOPS 最高为 192,000,即最多 16 个 MDS,1,000 TiB 时按这一上限计算。以上是我们根据文档规则推算的结果,请以实际创建的文件系统为准。
- 客户端:CSI 驱动节点 DaemonSet 的每个 Pod 也各占用一个 IP 地址。
数据量从 100 TiB 增长到 1,000 TiB 时,Amazon EFS 和 Mountpoint for Amazon S3 的 IP 地址消耗不变,FSx for Lustre 则明显增加。以未启用 EFA 为例,仅文件系统服务端就需要约 443 个 IP 地址(427 个 OSS 加 16 个 MDS),超过了一个 /24 子网的可用地址数(251 个),因此需要提前规划更大的子网;启用 EFA 后,同样容量所需的服务端 IP 地址会少很多。
以上估算基于 VPC CNI 的默认模式(secondary IP 模式)。启用前缀委派(prefix delegation)后,子网按 /28 前缀分配地址,消耗粒度会有所不同。规划子网时,还需要为业务 Pod、节点主 IP 地址、预热池、滚动发布和扩缩容留出余量。
5.2 成本结构分析
我们按 us-east-1 的按需价格,估算了 100 TiB 和 1,000 TiB 数据每月要花多少钱(单位:美元)。这里只算了存储、读取和吞吐的费用,Amazon EFS 的写入费、Amazon S3 的请求费、跨可用区流量、备份、税和折扣都没有算进去,实际金额以账单为准。
FSx for Lustre 的存储容量需要按规定的增量取整:
- 未启用 EFA 时,按 2,400 GiB 递增,100 TiB 取整为 103,200 GiB,1,000 TiB 取整为 1,024,800 GiB;
- 启用 EFA 时,按吞吐档位递增,125/250/500/1000 档位的增量分别为 38,400/19,200/9,600/4,800 GiB。
另外,单个 Persistent 2 文件系统的容量上限为 1,200,000 GiB;账户级的 Persistent 2 存储容量默认配额为 100,800 GiB,本文的两个场景都超过了这一默认值,需要提前申请提高配额。
| 方案 | 100 TiB | 1,000 TiB | 单价 |
| Amazon S3 Standard | $2,304 | $22,067 | 前 50 TB 每 GB $0.023,50–500 TB 每 GB $0.022,超过 500 TB 每 GB $0.021 |
| Amazon EFS Regional Elastic,每月读取全量数据 1 次 | $33,792 | $337,920 | 存储每 GB $0.30,读取每 GB $0.03,写入每 GB $0.06 |
| Amazon EFS Regional Elastic,每月读取全量数据 10 次 | $61,440 | $614,400 | 同上 |
| Amazon EFS Provisioned 3,414 MiB/s | $32,772 | $309,252 | 存储每 GB $0.30,超出基线的吞吐每 MiB/s 每月 $6(计算方法见下文) |
| FSx for Lustre Persistent 2,125 MB/s/TiB | $14,964(启用 EFA:$16,704) | $148,596(启用 EFA:$150,336) | 每 GB $0.145 |
| FSx for Lustre Persistent 2,250 MB/s/TiB | $21,672(启用 EFA:$24,192) | $215,208(启用 EFA:$217,728) | 每 GB $0.21 |
| FSx for Lustre Persistent 2,500 MB/s/TiB | $35,088(启用 EFA:$35,904) | $348,432(启用 EFA:$349,248) | 每 GB $0.34 |
| FSx for Lustre Persistent 2,1000 MB/s/TiB | $61,920(启用 EFA:$63,360) | $614,880(启用 EFA:$616,320) | 每 GB $0.60 |
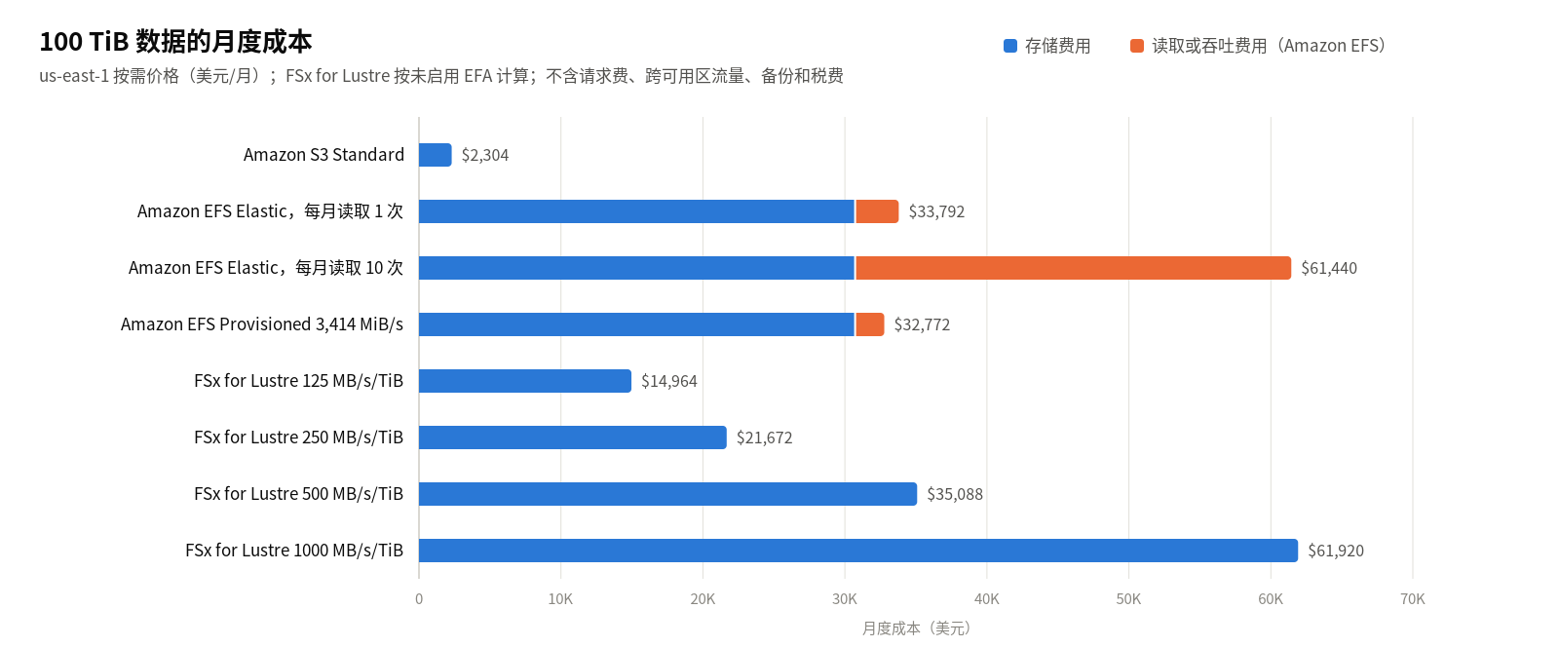 [图 3:100 TiB 数据的月度成本] |
Amazon EFS 的读取或吞吐费用单独标出;FSx for Lustre 按未启用 EFA 计算。1,000 TiB 时各项成本基本按 10 倍增长,Amazon S3 因阶梯价略低于 10 倍。
Amazon EFS Provisioned 模式的吞吐费用按以下方法计算:
- 计费规则:Provisioned 模式只对超出 Standard 存储所含基线吞吐的部分计费,单价为每 MiB/s 每月 6 美元。
- 基线吞吐:每 TiB 50 MiB/s,且不超过所在区域 Bursting 模式的吞吐上限。100 TiB 对应的基线吞吐理论上为 5,000 MiB/s,这里按 us-east-1 区域 Bursting 模式的写入上限 3 GiB/s(即 3,072 MiB/s)计算。
- 预置值:3,414 MiB/s 是 us-east-1 区域单个文件系统默认的 Provisioned 吞吐上限(3.33 GiB/s),对应最高 10 GiB/s 的读取吞吐。
- 计费部分:(3,414 − 3,072) × 6 = 2,052 美元。1,000 TiB 时基线同样按 3,072 MiB/s 封顶,吞吐费用不变。
单看上表,Amazon S3 比两类文件系统便宜数倍到十几倍,很容易据此只按每 GB 单价来选。但把读写流量、吞吐和分层组合算进来,结果会不一样。
Amazon EFS Elastic 模式按读写流量计费。 这一点最容易被忽略。Elastic 模式除了每 GB $0.30 的存储费,读取每 GB 还要 $0.03,写入每 GB $0.06。数据集每被完整读一遍,就要再付一次读取费:100 TiB 的数据每月读 10 遍,读取费会从 3,072 美元涨到 30,720 美元,和存储费一样多。写入也是同样的道理,如果把检查点放在 Amazon EFS 上,每小时写一次 2 TB(按 2,000 GB 计),一个月光写入费就要约 86,400 美元(估算)。所以,读写量大而且比较稳定的负载更适合 Provisioned 模式:持续读取 1 MiB/s,Elastic 模式每月的读取费约 76 美元(估算),而 Provisioned 模式每 MiB/s 每月是 6 美元。
按吞吐折算的单位成本。 约 100 TiB、未启用 EFA 的 FSx for Lustre,四个档位的基线磁盘吞吐分别约为 12.6、25.2、50.4 和 100.8 GB/s,折合每 GB/s 每月约 1,188、860、696 和 614 美元。档位越高,单位吞吐反而越便宜。1,000 TiB 时单位吞吐成本与此相同。所以选档位时,先算清楚需要多少吞吐,再看每 GB 单价。
分层组合。 如果让 FSx for Lustre 再存一份全量数据,相当于为冷数据也付了高性能存储的钱,而 Amazon S3 里本来就有全量。下表在 Amazon S3 存储全量 100 TiB 的前提下,比较”FSx for Lustre 存储全量数据”和”FSx for Lustre 只存储热数据”两种做法。两种做法都计入了 Amazon S3 的费用,FSx for Lustre 按未启用 EFA 计算:
| 方案 | FSx for Lustre 容量 | 月度成本(含 Amazon S3) | FSx for Lustre 基线吞吐 |
| 125 档位存储全量数据 | 103,200 GiB | $17,268 | 约 12.6 GB/s |
| 热数据占 20%,250 档位 | 21,600 GiB | $6,840 | 约 5.3 GB/s |
| 热数据占 10%,1000 档位 | 12,000 GiB | $9,504 | 约 11.7 GB/s |
| 热数据占 20%,1000 档位 | 21,600 GiB | $15,264 | 约 21.1 GB/s |
| 热数据占 40%,1000 档位 | 43,200 GiB | $28,224 | 约 42.2 GB/s |
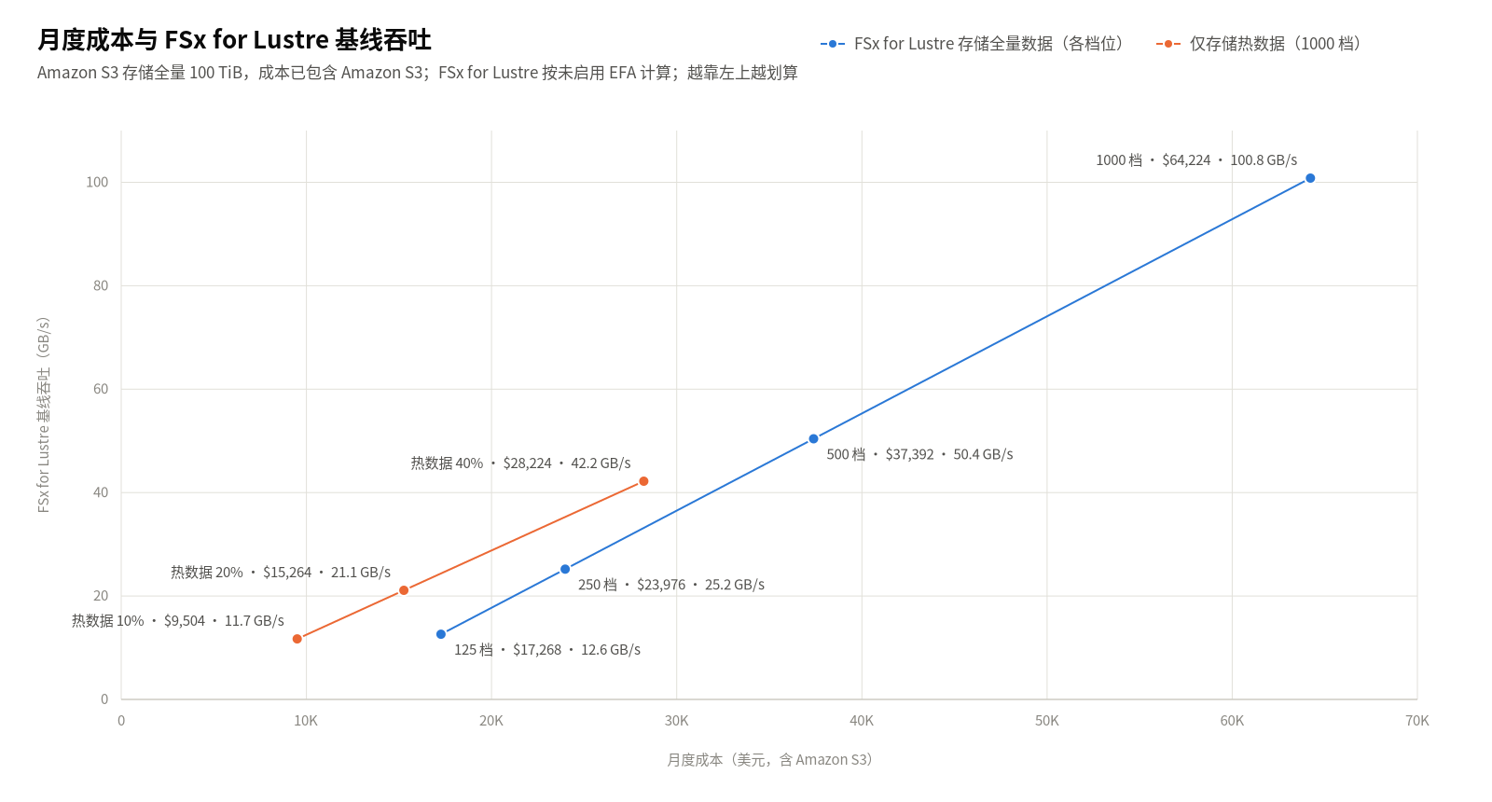 [图 4:月度成本与 FSx for Lustre 基线吞吐] |
成本均包含 Amazon S3 存储全量数据的费用;“仅存储热数据”一组的吞吐只服务于热数据集。
在热数据占 20% 的情况下,用 1000 档位只存储热数据,比用 125 档位存储全量数据便宜约 12%,基线吞吐却高出约 67%。按 EFA 的容量增量计算,结论相同:月度成本为 16,704 美元对比 19,008 美元,基线吞吐约为 23.4 GB/s 对比 14.1 GB/s。数据量为 1,000 TiB 时结论类似:热数据占 20% 时,1000 档位只存储热数据为每月 145,907 美元、约 201.6 GB/s,125 档位存储全量数据为每月 170,663 美元、约 125.1 GB/s,前者便宜约 15%,吞吐高约 61%。
这个结论有三个前提:热数据集能够被准确识别,并且放得进 FSx for Lustre;冷数据第一次被访问时,需要通过数据存储库关联(Data Repository Association,DRA)从 Amazon S3 按需加载,或者在训练前完成预热,首次访问会慢一些;如果热数据集变化频繁,反复导入和释放还会产生额外的 Amazon S3 请求费用,上表没有计入这部分。
如果热数据比例不高、读取以大块顺序读为主,也可以评估 FSx for Lustre 的 Intelligent-Tiering 存储类别。它把吞吐和容量分开计费:吞吐按 MBps 计费,容量按访问频率分层计费;如果小 I/O 随机读较多,则需要配置 SSD 读取缓存。
所以比较成本时,建议把存储费用摊到每次训练任务或每个 GPU 小时上看。
5.3 POSIX 语义与多租户配额
多个团队共用一个训练平台时,谁能写哪些目录、最多能写多少,都需要管起来。三项服务在这方面的能力差别很大。
FSx for Lustre 支持按用户、组和项目设置存储容量(block)和文件数量(inode)配额,可以设置硬限制,也可以设置有宽限期的软限制。项目配额只在 Lustre 2.15 版本的文件系统上可用。配合 root squash(将客户端的 root 用户映射为受限的 UID/GID),可以防止容器以 root 身份绕开权限控制。
Amazon EFS 不支持用户、目录或项目级别的配额。通过 EFS 访问点可以强制指定 POSIX 用户身份和根目录,实现目录级隔离,但无法限制存储容量。
Mountpoint for Amazon S3 不提供 POSIX 意义上的配额,访问控制依靠 IAM 策略和存储桶策略。
在 Kubernetes 中,建议通过 runAsNonRoot、runAsUser、runAsGroup 和 fsGroup 让容器身份与文件属主保持一致,再按用途划分共享路径,例如 /datasets 只读、/checkpoints 可写、/projects/<team> 由各团队独立管理。
团队目录可以通过属主、属组和权限位来隔离。FSx for Lustre 官方文档没有说明是否支持 POSIX ACL,因此我们不建议依赖 setfacl。下面是配置 Lustre 项目配额的示例,命令写法参考 FSx for Lustre 官方文档:
# 1. 团队目录:属主和属组与 Pod 的 runAsUser / fsGroup 保持一致,setgid 使新文件继承属组
sudo chown 10001:20001 /fsx/projects/team-a
sudo chmod 2770 /fsx/projects/team-a

# 2. 将目录及其下所有文件关联到项目 31001(-r 表示递归,-s 表示新建文件继承项目 ID)
sudo lfs project -p 31001 -r -s /fsx/projects/team-a

# 3. 设置项目配额:块配额的单位为 KB
#    软限制 5 TiB = 5,368,709,120 KB,硬限制 5.5 TiB = 5,905,580,032 KB
#    文件数软限制 5,000 万,硬限制 5,500 万
sudo lfs setquota -p 31001 -b 5368709120 -B 5905580032 -i 50000000 -I 55000000 /fsx

# 4. 查看项目的用量和配额
lfs quota -p 31001 /fsx
使用配额时要留意两件事。超出软限制后,宽限期内仍可继续写入(默认一周),这期间不会有任何通知或告警,用量需要自行监控;超出硬限制或宽限期结束后,写入会失败,并返回 Disk quota exceeded 错误。另外,配额对 root 用户不生效,使用 sudo 写入也会绕过配额,因此配额一定要和 runAsNonRoot、root squash 一起使用。
在 Amazon EKS 上,FSx for Lustre 的多租户方案还需要结合容器的使用方式来设计,例如 Pod 的身份与 securityContext 配置、PV 和 PVC 如何按团队或项目划分,以及 CSI 驱动的挂载参数。这部分内容较多,我们会在后续文章中单独介绍。
六、常见性能瓶颈与优化建议
从我们的项目经验看,存储性能出问题,多数时候是访问模式和服务特性没对上,服务本身选错的情况反而不多。
6.1 Amazon S3
常见瓶颈:小对象的请求开销;503 Slow Down 错误与热点前缀;ListObjectsV2 调用次数放大。
优化建议
- 通过前缀分散请求并保持分片稳定,在客户端实现 503 错误的退避重试。
- 将小文件打包为大分片。
- 优先使用基于 AWS Common Runtime(CRT)的客户端,如 Mountpoint for Amazon S3、Amazon S3 Connector for PyTorch 和 AWS CLI 的 CRT 传输客户端,并用真实的 DataLoader 和 GPU step time 验证效果。
- 小对象多、请求密集的热数据,可以考虑 S3 Express One Zone(见 4.4 节)。
6.2 Amazon EFS
常见瓶颈:单客户端吞吐上限;热点目录与元数据 p99 延迟;不支持硬配额。
优化建议
- 通过多客户端并发提升聚合吞吐。
- 对目录进行分片,并采用大文件格式。
- 根据负载特征选择 Elastic 或 Provisioned 吞吐模式。
- 使用 EFS 客户端 v2.0 及以上版本或 EFS CSI 驱动挂载,以获得 1,500 MiB/s 的单客户端吞吐上限。
- 对于需要周期性重复读取的数据,将生命周期策略中的”转回 Standard”设置为首次访问时转换。
6.3 Amazon FSx for Lustre
常见瓶颈:跨可用区访问带来的延迟与流量费用;小文件的元数据瓶颈;条带配置与访问模式不匹配。
优化建议
- 将计算资源与文件系统部署在同一可用区。
- 小于 100 MiB 的文件保持 1 个条带(新建文件系统的默认布局),检查点等超大文件存放在高条带数的目录中。
- 客户端不经 EFA 访问时(包括未启用 EFA 的文件系统),单个客户端到单个存储服务器的流量上限为 5 Gbps,单文件的读写吞吐需要靠条带化来提升。
- 按需配置元数据 IOPS,并将单个目录的文件数控制在 10 万以内。
- 吞吐容量超过 10 GBps 时建议启用 EFA。
- 将维护窗口安排在训练间隙;维护完成后内存缓存会被清空,短时间内延迟会有所升高。
七、分层参考架构
7.1 典型生产架构
将几项服务组合使用时,最常见的形态是:Amazon S3 作为唯一数据源,在其上再加一层高性能文件系统(图 5)。
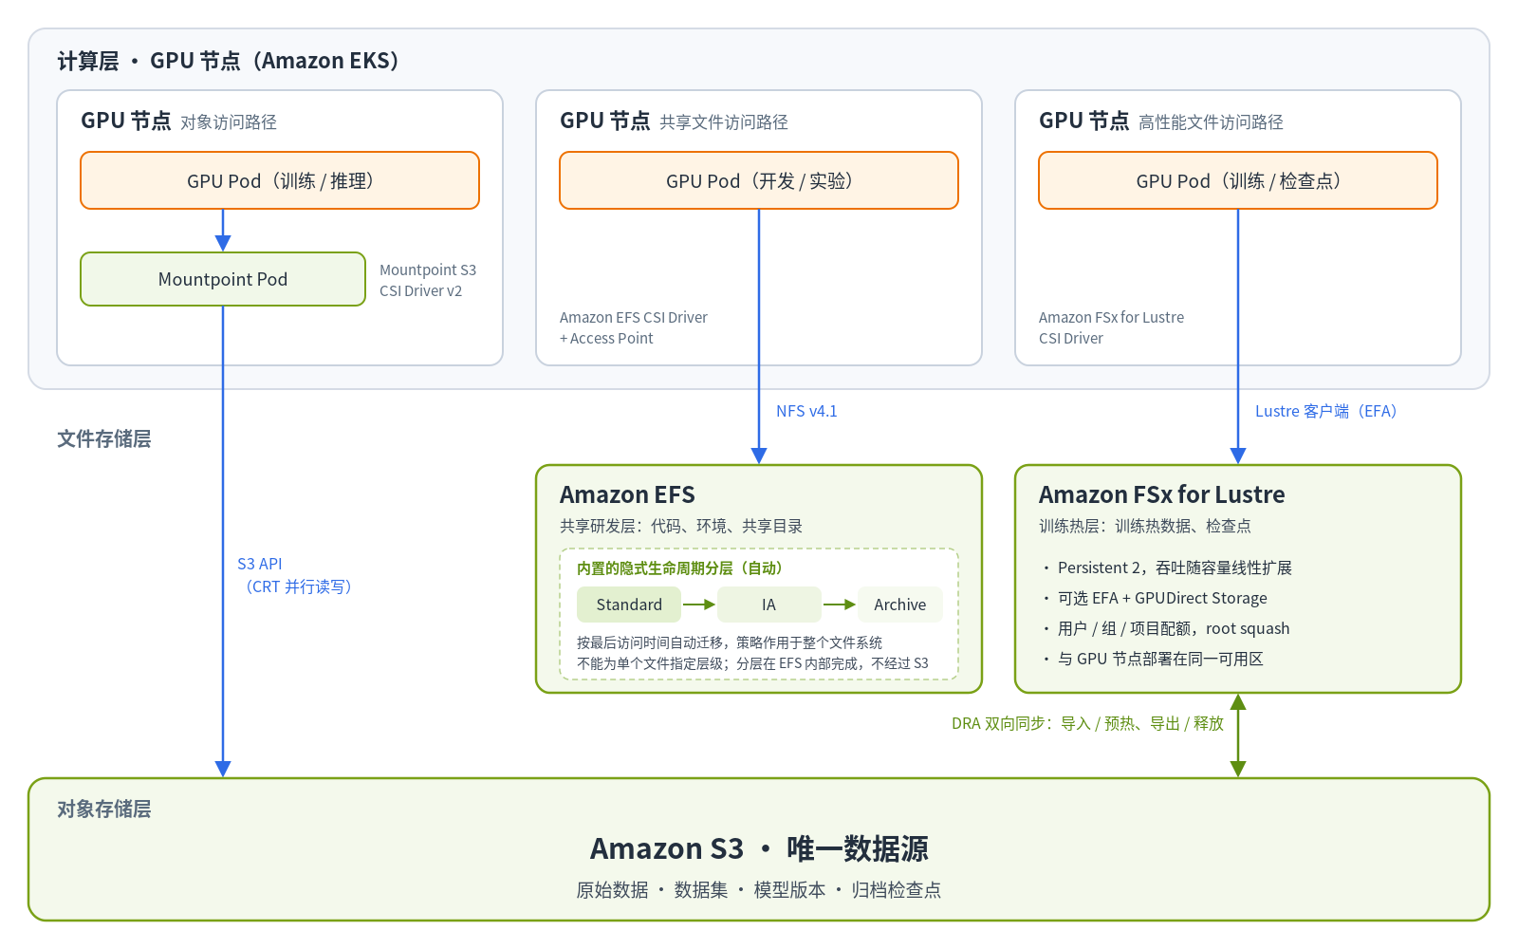 [图 5:典型生产架构] |
GPU 节点分别通过 Mountpoint for Amazon S3 访问 Amazon S3、通过 NFS 访问 Amazon EFS、通过 Lustre 客户端访问 FSx for Lustre;FSx for Lustre 通过 DRA 与 Amazon S3 双向同步;Amazon EFS 的冷热分层在文件系统内部自动完成,不经过 Amazon S3。
数据在这套架构中的流转过程如下:
- 原始数据和数据集统一存放在 Amazon S3;
- 训练开始前,通过 DRA 导入元数据并预热热数据,训练读取和检查点写入都由 FSx for Lustre 承担;
- 检查点通过 DRA 自动导出,回写到 Amazon S3;
- 训练结束后,释放文件系统中的冷数据,再由 Amazon S3 生命周期策略逐步将数据转移到成本更低的存储类别。
Amazon EFS 也有自己的冷热分层:生命周期管理会根据文件最后一次被访问的时间,在 Standard、Infrequent Access 和 Archive 三个存储类别之间自动迁移数据。不过,这套策略作用于整个文件系统,无法为单个文件或目录指定存储层级。
7.2 五层存储模型
按照读写强度和容量规模,可以把 AI 平台的存储分为五层:
| 层级 | 存储介质或服务 | 存放的数据 | 特征 |
| 推理与状态层 | GPU 显存、主机内存、本地 NVMe;需要跨节点共享时使用 FSx for Lustre | KV cache、prefix cache、模型权重缓存 | 热数据、低延迟 |
| 节点缓存层 | GPU 实例本地 NVMe | 单个 epoch 内复用的数据、异步检查点暂存 | 数据复用、临时暂存 |
| 训练热层 | FSx for Lustre + DRA | 训练热数据、检查点 | 高并发、突发写入 |
| 共享研发层 | Amazon EFS | 代码、开发环境、团队共享目录 | 多可用区共享读写 |
| 长期容量层 | Amazon S3 | 原始数据、模型版本、归档检查点 | 大容量、低成本 |
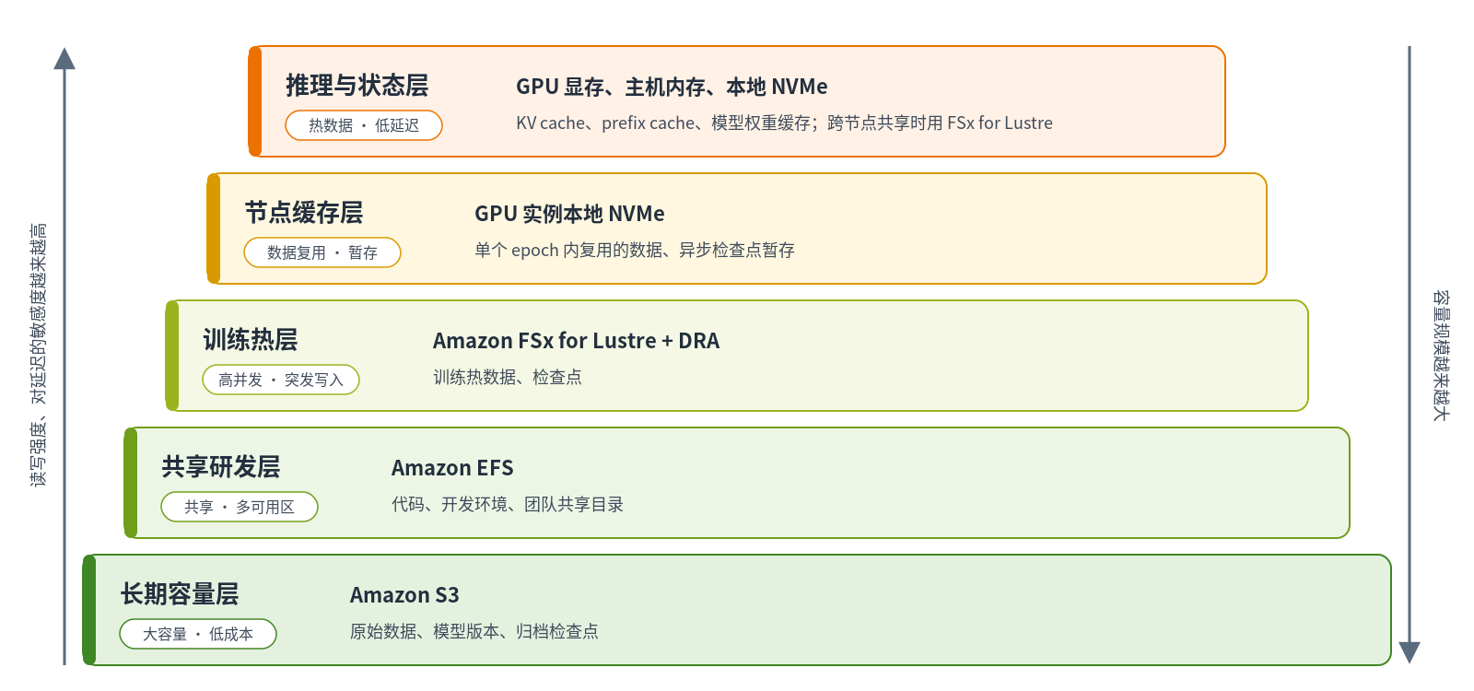 [图 6:五层存储模型] |
自上而下,读写强度和对延迟的敏感度递减,容量规模递增。
节点缓存层也是异步检查点最常用的落点。如果使用 Amazon SageMaker HyperPod,可以直接采用它的托管分层检查点(managed tiered checkpointing):检查点先写入集群的 CPU 内存并在节点间复制,再定期持久化到 Amazon S3。
推理侧的 KV cache 正在形成”HBM → 主机内存 → 本地 NVMe → 共享存储”的多级结构:HBM 和主机内存放不下时,单个节点溢出的部分由本地 NVMe 承接,需要跨节点共享的部分由 FSx for Lustre 承载,再往下由 Amazon S3 负责持久化。
八、选型方法与验证建议
我们通常按照”先语义、再性能、最后看成本和运维”的顺序做选型:
- 访问语义:应用需要的是对象 API、NFS,还是完整的 POSIX 语义?先用语义排除不兼容的方案。
- I/O 特征:工作负载属于小文件、大分片还是检查点类型?可以先统计文件数量与大小分布、目录深度、每秒 open/stat/readdir 操作次数和吞吐需求,再据此确定需要验证的性能指标和服务等级目标(SLO),例如可接受的 GPU 等待时间、检查点的保存和恢复时间。
- 数据生命周期:数据是需要长期保存的唯一数据源、临时热数据,还是会被多次扫描的数据?
- 成本与运维:把容量、I/O、网络、资源预置与维护、故障恢复等因素都折算成每次训练任务的成本。
走完这四步,得到的通常是一个组合,即 Amazon S3 加上 Amazon EFS 或 FSx for Lustre:Amazon S3 负责长期容量和对象原生访问,Amazon EFS 负责共享开发环境和便捷的 NFS 访问,FSx for Lustre 负责并行训练和高频检查点。
选型结论最后还要靠实测来验证。测试时请使用真实的训练代码和数据格式:fio 等基准测试工具只覆盖块式读写,反映不了 DataLoader 的访问方式、目录遍历和真实的检查点写入。冷缓存和热缓存、单任务和多租户并发、节点故障和扩容期间的表现,都要测到。记录的指标也不要只有带宽,还应包括 GPU 利用率、GPU 等待时间、step time、元数据操作速率、p99 延迟、检查点保存与恢复时间,以及从 Amazon S3 回源的数据量。最后,把存储成本折算到每次训练任务和每个 GPU 小时。
九、总结
AI 平台的存储需求,很难靠一项服务全部满足。我们的建议是这样分工:
- Amazon S3 作为数据底座:数据集、模型版本和归档的检查点最终都应保存在 Amazon S3 中。
- FSx for Lustre 作为训练热层:适合需要 POSIX 语义、亚毫秒级延迟或单客户端数百 Gbps 吞吐的场景,通过 DRA 与 Amazon S3 协同;档位按吞吐需求选择,容量优先留给热数据。
- Amazon EFS 作为共享研发层:适合代码、开发环境和团队共享目录,多可用区、免运维,但要留意单客户端吞吐上限和按量计费带来的成本。
- 本地 NVMe 与 KV cache 分层:承担节点级缓存和推理状态的存储。
此外,VPC IP 地址消耗、成本结构、POSIX 语义和配额管理,也应当与性能一起纳入评估。
判断一套存储架构是否合适,可以看三件事:GPU 是否一直有数据可读,出故障后多久能恢复,成本能不能说清楚。如果暂时只能先做一件事,建议先统计现有数据集的文件数量和大小分布,它在很大程度上决定了后面该选哪一类存储。
文中的规格和价格都以 us-east-1 为例,其他区域可能有差异,价格也可能调整,请以官方文档和定价页面为准。
 下一步行动:
相关产品:
- Amazon S3 — 适用于 AI、分析和存档的几乎无限的安全对象存储
- Amazon EFS — 弹性文件存储
- Amazon EKS — 托管式 Kubernetes 服务
- Amazon VPC — 隔离云网络
- Amazon SageMaker — 适用于所有数据、分析和 AI 的中心
相关文章:
- Amazon Bedrock AgentCore 数据持久化文件系统:Session Storage 和 Amazon EFS / S3 Files
- Mountpoint S3 与 S3 Files 在 EKS 上的实战对比
- Amazon EFS 目录级配额监控:多租户 SaaS方案
- 多租户 AI agent 的数据安全:Amazon FSx for NetApp ONTAP 的访问边界与会话防护
十、参考资料
- Amazon S3 性能优化最佳实践
- S3 Express One Zone 支持的可用区
- Amazon S3 FAQ(含 S3 Express One Zone 计费与跨可用区访问)
- Mountpoint for Amazon S3 语义说明
- Mountpoint for Amazon S3 CSI 驱动的 Pod 共享机制
- Amazon S3 Files 发布博客
- Mountpoint S3 与 S3 Files 在 EKS 上的实战对比
- EKS 上的 GPU 工作负载:节点、网络与高性能存储的架构实践
- Amazon EFS 性能规格
- Amazon EFS 生命周期管理
- Amazon EFS 访问点
- Amazon EFS 配额(含 Bursting 和 Provisioned 吞吐上限、文件锁)
- FSx for Lustre 性能(含条带化和单客户端吞吐)
- FSx for Lustre 性能提示
- FSx for Lustre 挂载(含 flock 选项)
- FSx for Lustre 存储配额
- FSx for Lustre root squash
- FSx for Lustre 维护窗口
- FSx for Lustre 与 Amazon S3 的数据存储库关联
- FSx for Lustre 存储容量增量(含 EFA 文件系统)
- FSx for Lustre 入门与前提条件(每个 MDS、OSS 各占用一个 IP 地址)
- FSx for Lustre EFA 文件系统
- FSx for Lustre 元数据性能(含 Automatic 模式和元数据 IOPS 上限)
- FSx for Lustre 配额(含 Persistent 2 默认存储容量配额和单个文件系统容量上限)
- Amazon SageMaker HyperPod 托管分层检查点
- Fast model loading for AI inference on Amazon EKS
- Accelerate inference with KV cache tiering on AWS
- 定价页面:https://aws.amazon.com/s3/pricing/ 、https://aws.amazon.com/efs/pricing/ 、https://aws.amazon.com/fsx/lustre/pricing/ (文中价格按 us-east-1 计算)
*前述特定亚马逊云科技生成式人工智能相关的服务目前在亚马逊云科技海外区域可用。亚马逊云科技中国区域相关云服务由西云数据和光环新网运营,具体信息以中国区域官网为准。
本篇作者
石永铮
亚马逊云科技解决方案架构师,负责游戏行业客户云上架构设计。曾在网易游戏从事 7 年游戏运维与 GPU 集群、AI 中台建设,保障过多款大 DAU 游戏中 AI 玩法的稳定上线。目前专注于帮助客户在云上构建 AI Infra,落地大规模训练与推理方案。
谢志鹏
亚马逊云科技高级解决方案架构师,专注 GPU 与 AI 基础设施,支持头部互联网和游戏客户的大模型训练、推理平台架构设计与落地。曾在亚马逊云科技支持多家知名游戏公司的全球发行项目。拥有十年以上 IT 架构与运维经验,在云安全、网络、存储、微服务架构等方面有丰富的实战经验
AWS 架构师中心:云端创新的引领者探索 AWS 架构师中心,获取经实战验证的最佳实践与架构指南,助您高效构建安全、可靠的云上应用
|
 |
原文发布于 AWS 中国博客,正文由采集器自动抓取,版权归来源站点所有。

